Git por dentro: como funciona o controle de versão que guarda a história do seu código
Commits, ramos, merge, rebase e remotos explicados de dentro para fora. Entenda como o Git guarda cada versão, por que criar ramos custa quase nada e como desfazer erros sem perder trabalho, com exemplos reais e as práticas que usamos na Gothor.
Todo software que está em produção hoje passou por milhares de mudanças: uma correção às pressas numa sexta-feira, uma funcionalidade que levou três semanas, uma refatoração que ninguém queria fazer. Saber o que mudou, quando, por quem e por quê é o que separa uma equipe que conserta um problema em minutos de uma que passa a tarde procurando o culpado. Quem guarda essa memória, em praticamente todos os projetos de software do mundo, é o Git.
A maioria das pessoas aprende meia dúzia de comandos (add, commit, push, pull) e segue em frente até o dia em que algo dá errado: um conflito que não faz sentido, um commit que "sumiu", um push recusado. Este artigo faz o caminho inverso. Começa pelo que o Git é por dentro, porque, quando o modelo mental está certo, os comandos deixam de ser fórmulas decoradas e passam a ser consequências óbvias.
O que é o Git, e o que ele não é
O Git é um sistema de controle de versão distribuído. Controle de versão é o registro organizado de todas as mudanças de um conjunto de arquivos, com a possibilidade de voltar a qualquer ponto, comparar versões e combinar o trabalho de várias pessoas. Distribuído significa que cada cópia do repositório é completa: o computador de cada desenvolvedor tem o histórico inteiro, e não só a versão mais recente.
Essa segunda parte é a grande diferença em relação aos sistemas centralizados que vieram antes, como o CVS e o Subversion. Neles existia um servidor com o histórico, e cada pessoa tinha apenas uma "cópia de trabalho". Sem acesso ao servidor, não havia como consultar o histórico, criar um ramo ou registrar uma mudança. No Git, quase tudo acontece localmente: log, diff, commit, branch e merge funcionam no avião, sem internet, e respondem em milissegundos.
Também vale separar duas coisas que costumam ser confundidas:
- Git é a ferramenta: um programa de código aberto que roda no seu computador.
- GitHub, GitLab e Bitbucket são serviços que hospedam repositórios Git e acrescentam recursos de colaboração, como pull requests, revisão de código, issues e integração contínua.
Você pode usar Git sem nenhum desses serviços. O inverso não é possível.
Uma história curta: o Git nasceu de uma crise
Antes do Git: três décadas de controle de versão
A necessidade de guardar versões de código é quase tão antiga quanto o próprio software. Em 1972, nos Bell Labs, Marc Rochkind criou o SCCS (Source Code Control System), que guardava o histórico de cada arquivo isoladamente e exigia que a pessoa "travasse" o arquivo antes de editá-lo. Dez anos depois, Walter Tichy publicou o RCS (Revision Control System), mais simples e mais rápido, mas com a mesma limitação de fundo: ele versionava arquivos, um a um, e não o projeto como um todo.
O CVS (Concurrent Versions System), que ganhou a sua versão mais conhecida por volta de 1990, deu o passo seguinte: um servidor central guardava o histórico de um projeto inteiro, e várias pessoas podiam editar o mesmo arquivo ao mesmo tempo, combinando as mudanças depois. Foi o padrão do software livre durante a década de 1990. Em 2000 começou o Subversion (SVN), criado para ser "um CVS melhor": commits atômicos (ou entram todas as mudanças, ou nenhuma), renomeação de arquivos com histórico e operações mais confiáveis. O Subversion dominou os anos 2000 e ainda existe em muitas empresas.
Todos esses sistemas compartilhavam um desenho: o histórico mora num lugar só. Isso tem vantagens administrativas, mas cobra caro em três pontos. Toda operação de histórico depende da rede e do servidor; criar e integrar ramos é lento e arriscado, então as equipes evitam fazê-lo; e quem não tem permissão de escrita no servidor central não consegue nem registrar o próprio trabalho em etapas.
O BitKeeper e a ruptura de 2005
Nos anos 2000 surgiram os primeiros sistemas distribuídos, em que cada pessoa tem uma cópia completa do histórico. Um deles, o BitKeeper, da empresa BitMover, passou a ser usado no desenvolvimento do kernel do Linux em 2002, com uma licença gratuita cedida à comunidade, apesar de o produto ser proprietário. A escolha sempre foi polêmica entre os defensores do software livre, mas funcionava.
Em 2005, depois que um desenvolvedor da comunidade analisou o protocolo do BitKeeper para escrever um cliente livre compatível, a licença gratuita foi retirada. O projeto do kernel, um dos maiores e mais movimentados do mundo, ficou de uma hora para outra sem ferramenta.
Linus Torvalds decidiu escrever a sua própria. Os objetivos eram claros e moldam o Git até hoje: ser muito rápido, ter um desenho simples, suportar desenvolvimento não linear, com milhares de ramos em paralelo, ser totalmente distribuído e aguentar projetos do tamanho do kernel. Havia ainda um critério de integridade: tinha de ser impossível corromper o histórico sem que alguém percebesse, o que explica a escolha do hash criptográfico como identidade de tudo. Em poucos dias, em abril de 2005, o Git já versionava o próprio código. A versão 2.6.12 do kernel, de junho, foi a primeira publicada com ele. Em julho do mesmo ano, Junio Hamano assumiu a manutenção do projeto, papel que mantém há duas décadas, e a versão 1.0 saiu em dezembro.
O nome tem uma história à parte. Em inglês britânico, git é uma gíria para uma pessoa desagradável, e Linus brincou que dava a todos os seus projetos o próprio nome. O arquivo de apresentação original descrevia o Git como "o rastreador de conteúdo estúpido" (the stupid content tracker), uma forma irônica de dizer que ele faz pouco, mas faz muito bem. No mesmo mês e pelo mesmo motivo nasceu o Mercurial, de Matt Mackall, outro sistema distribuído que teve adoção grande por anos.
Do kernel ao padrão do mercado
As primeiras versões do Git eram um conjunto de comandos de baixo nível, que só especialistas usavam com conforto. O próprio projeto chama esses comandos de encanamento (plumbing): hash-object, cat-file, update-index, write-tree, commit-tree, update-ref. Por cima deles, ao longo dos anos, foi construída a porcelana (porcelain): os comandos amigáveis do dia a dia, como add, commit, log, merge e switch. A separação existe até hoje e é útil: os comandos de encanamento têm saída estável, feita para scripts, enquanto a porcelana pode mudar de formato para ficar mais legível.
O que tornou o Git o padrão, porém, não foi só a ferramenta, e sim o que se construiu em volta dela. O GitHub, lançado em 2008, juntou hospedagem, uma interface web agradável e, principalmente, o pull request como forma de colaborar com projetos de outras pessoas. O GitLab apareceu em 2011, com a opção de instalar a plataforma no próprio servidor, e o Bitbucket, que começou hospedando Mercurial, acabou abandonando esse formato em 2020 para ficar só com o Git. Em 2018, a Microsoft comprou o GitHub, depois de ela mesma ter migrado o código do Windows para o Git.
Na pesquisa anual do Stack Overflow de 2022, mais de 90% dos desenvolvedores disseram usar o Git. Hoje é difícil encontrar um projeto relevante que use outra coisa, e o Git se espalhou para fora do software: equipes versionam com ele documentação, configuração de servidores, infraestrutura, dados de referência e textos.
Mesmo consolidado, o Git continua mudando. Em 2019 ganhou os comandos switch e restore, mais claros que o antigo checkout; em 2020 passou a permitir escolher o nome do primeiro ramo (o GitHub trocou o padrão de master para main no mesmo ano); em 2021 adotou a estratégia de merge ort como padrão; e recebeu uma série de recursos para repositórios gigantes, que aparecem mais adiante neste artigo.
O Git 3.0 no horizonte
A série 2 do Git, aberta com uma versão 2.0 que mudou o comportamento padrão do git push e avisou a mudança com antecedência, chegou à versão 2.56 em setembro de 2026, sempre com o cuidado de não quebrar o que funciona. Algumas mudanças, porém, só cabem numa versão que avise a quebra no número, e o projeto mantém um documento público, o BreakingChanges, com o que está planejado para o Git 3.0:
- SHA-256 como padrão para os repositórios novos, no lugar do SHA-1. Os repositórios existentes continuam funcionando, e o projeto diz não ter planos de abandonar o SHA-1.
- Reftable como padrão para guardar as referências, um formato descrito mais adiante, na seção sobre a pasta
.git. - **
maincomo nome do primeiro ramo** em repositórios novos, o que hoje depende da configuraçãoinit.defaultBranch. - Remoção de comandos e mecanismos antigos, como o
git whatchanged, ogit pack-redundante os grafts, a forma antiga de "enxertar" um histórico em outro. - Uma regra de segurança mais restrita para repositórios sem diretório de trabalho (bare), que o Git deixa de descobrir sozinho ao entrar numa pasta.
O documento não traz data para o lançamento e lembra que versões com quebras costumam ser preparadas ao longo de vários anos. Na prática, quase tudo já pode ser experimentado: git init --object-format=sha256 cria um repositório com SHA-256, e git init --ref-format=reftable usa o novo formato de referências. O cuidado é com o ecossistema: um repositório SHA-256 não conversa com um remoto SHA-1, e os serviços de hospedagem e as ferramentas em volta precisam acompanhar a mudança.
Como o Git pensa: fotos, não diferenças
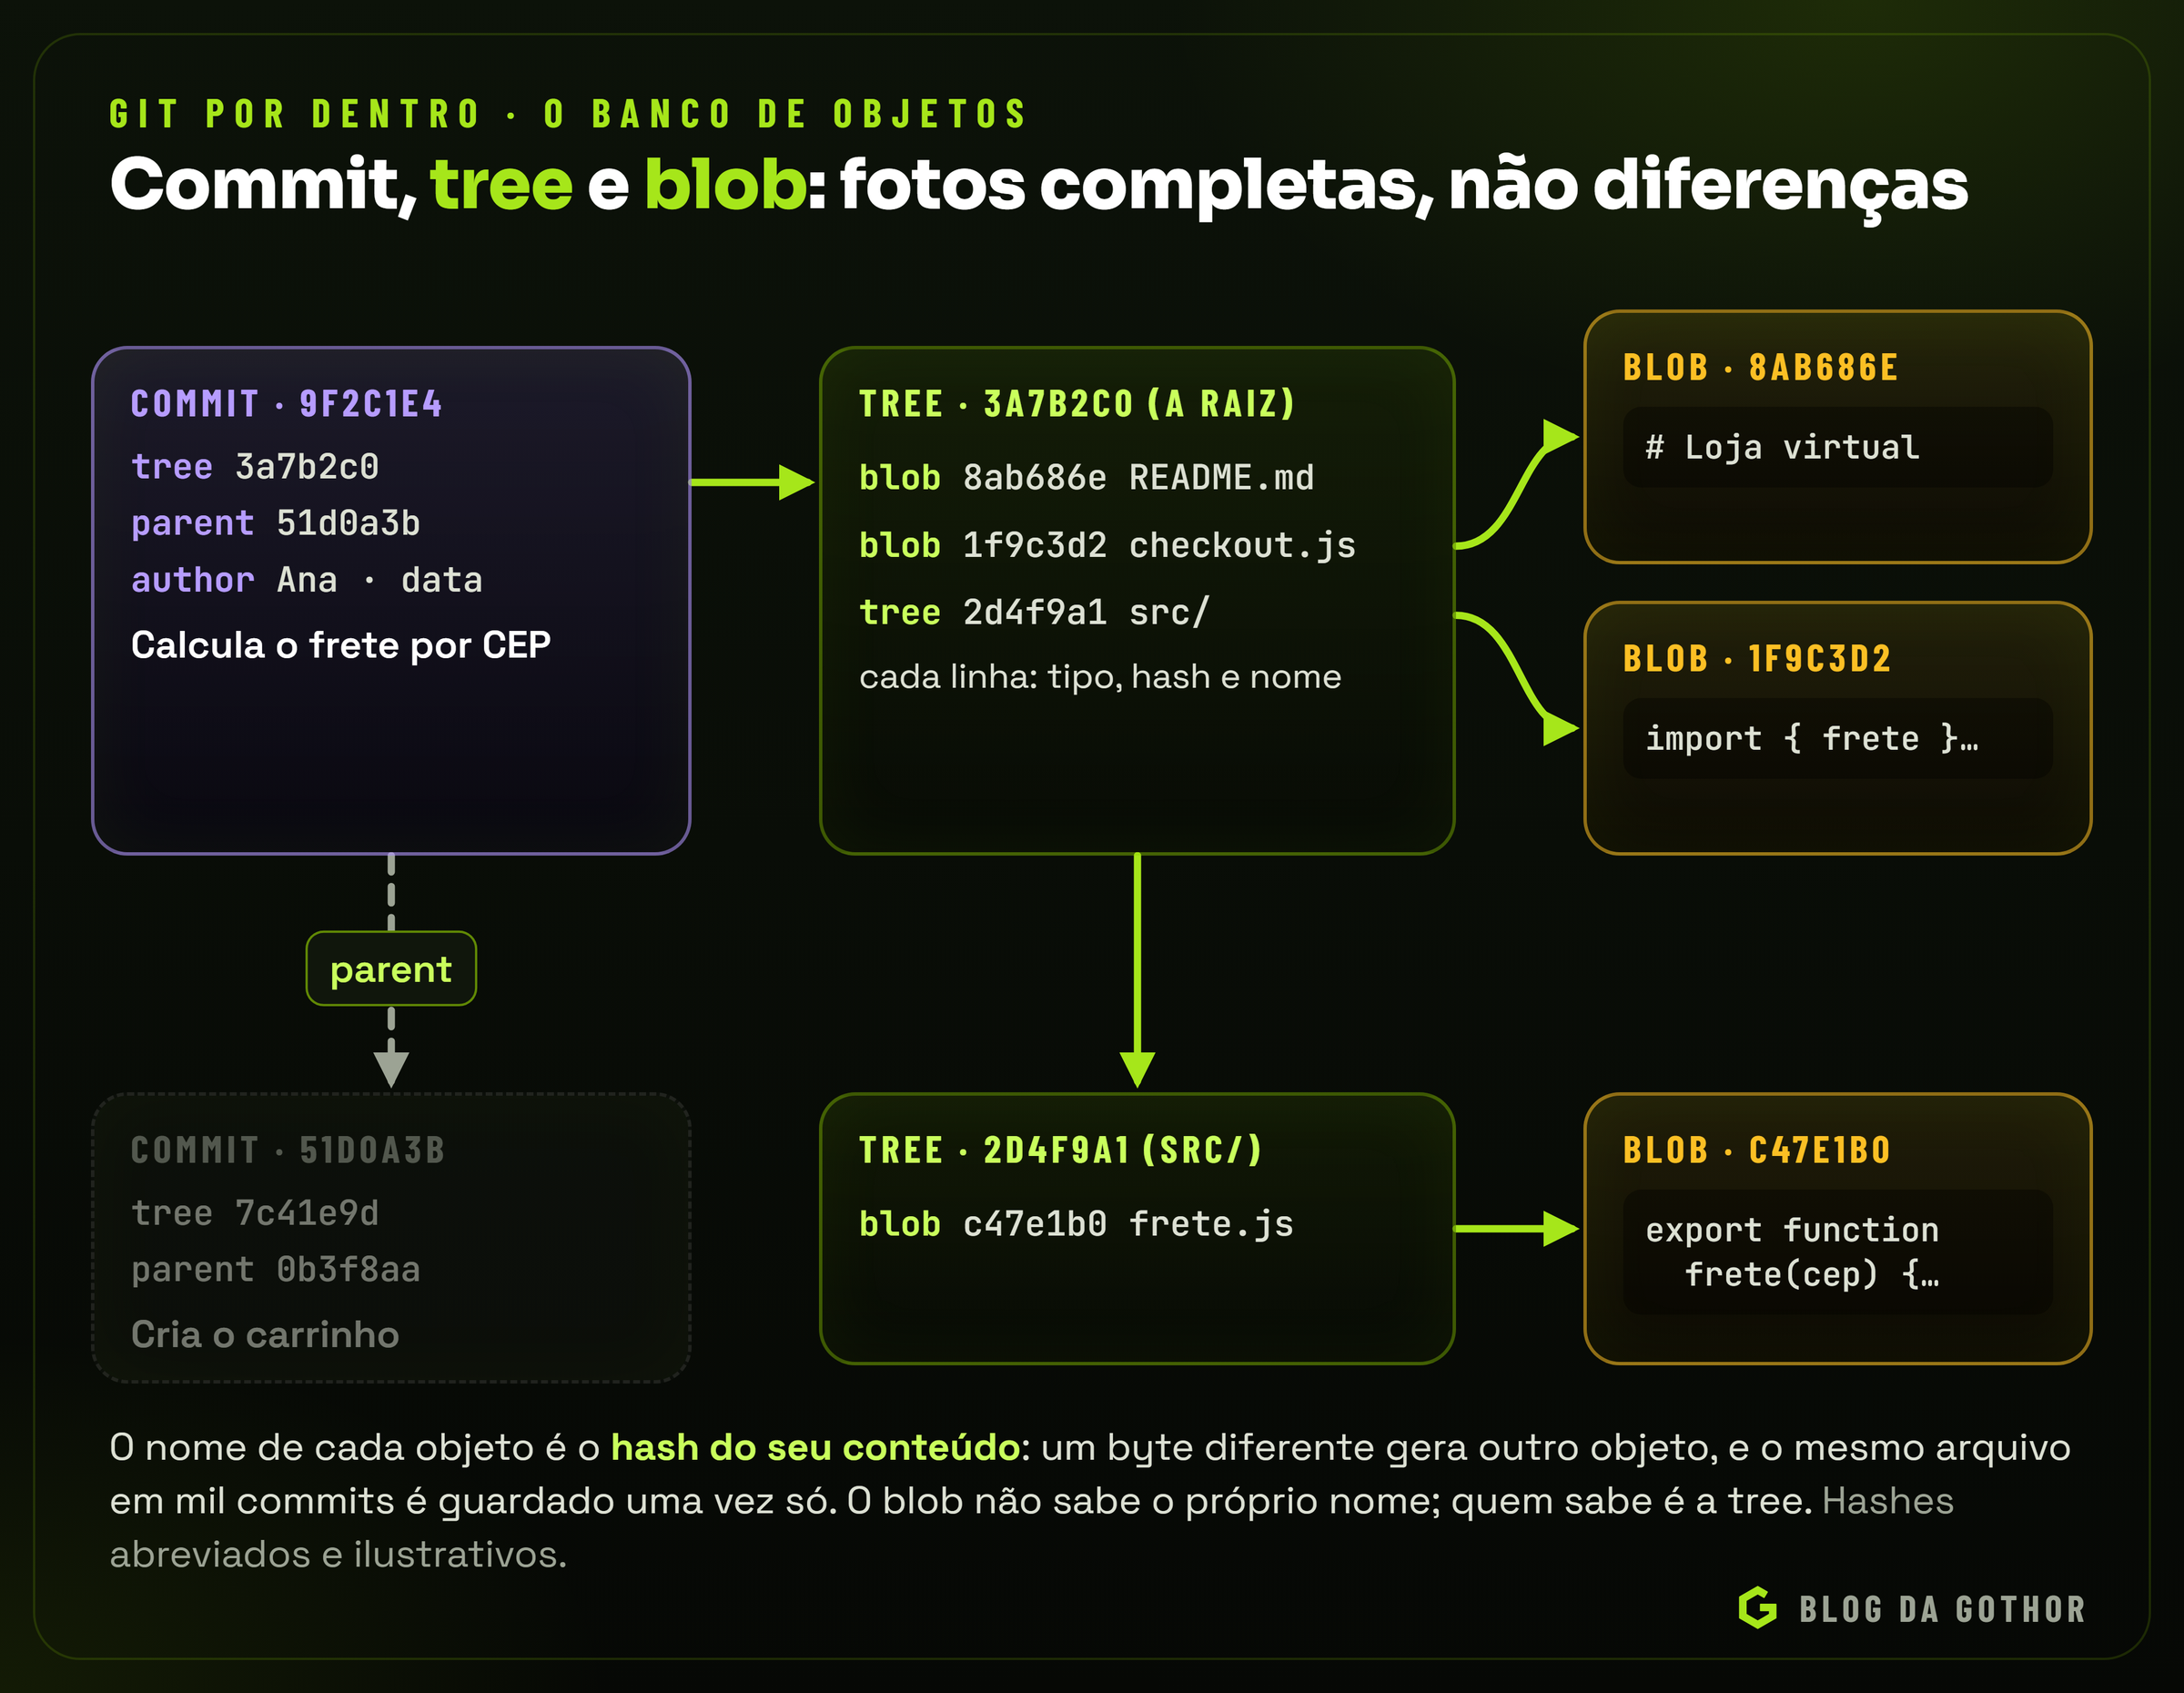
A ideia mais importante para entender o Git é esta: cada commit é uma foto completa do projeto, e não uma lista de diferenças em relação ao anterior.
Muitos sistemas antigos guardavam um arquivo base e uma sequência de alterações ("na linha 12, troque isto por aquilo"). O Git guarda, a cada commit, o estado de todos os arquivos. Isso parece um desperdício enorme de espaço, mas não é, por dois motivos que veremos a seguir: arquivos que não mudaram não são copiados de novo, e o armazenamento final é comprimido com deltas.
Os quatro tipos de objeto
Por dentro, a pasta .git é um pequeno banco de dados de objetos. São só quatro tipos:
- blob: o conteúdo de um arquivo, e nada mais. Nem o nome, nem a permissão, só os bytes.
- tree: uma pasta. Lista entradas com o tipo, o hash e o nome de cada arquivo (blob) ou subpasta (outra tree).
- commit: aponta para a tree da raiz do projeto naquele momento e registra o autor, a data, a mensagem e o commit anterior (o pai).
- tag anotada: um rótulo permanente para um commit, com autor, data e mensagem, usado para marcar versões.
Dá para ver tudo isso com os próprios comandos do Git. Num repositório de exemplo com um README.md e uma pasta src, o comando git cat-file -p mostra o conteúdo cru de cada objeto:
$ git cat-file -p HEAD
tree 1db6eeb7be8cf28bc8fd2857e42cb12e4957f3e0
author Ana <ana@exemplo.com.br> 1792414800 -0400
committer Ana <ana@exemplo.com.br> 1792414800 -0400

Cria a loja

$ git cat-file -p 'HEAD^{tree}'
100644 blob 955be2c96a48dcc1d8a71fb48210a635415868a0	README.md
040000 tree f888aa4fd1b3c1f04904277db64fd46959020895	src
Repare em dois detalhes. O commit não guarda arquivos: guarda o hash de uma tree. E o blob não sabe o próprio nome: quem sabe que aquele conteúdo se chama README.md é a tree. É por isso que renomear um arquivo sem alterá-lo não cria um blob novo.
O endereço é o próprio conteúdo
Cada objeto é identificado pelo hash do seu conteúdo, historicamente um SHA-1 de 40 caracteres hexadecimais. O Git calcula o hash sobre um pequeno cabeçalho (o tipo e o tamanho) mais o conteúdo. O resultado é determinístico: o mesmo conteúdo gera sempre o mesmo hash, em qualquer computador do mundo.
$ echo 'hello' | git hash-object --stdin
ce013625030ba8dba906f756967f9e9ca394464a
Rode esse comando na sua máquina e o resultado será idêntico. Essa propriedade, chamada de endereçamento por conteúdo, tem consequências práticas importantes:
- Deduplicação automática. Um arquivo que não mudou em mil commits é guardado uma única vez: todas as trees apontam para o mesmo blob.
- Integridade. Se um byte de um objeto for corrompido, o hash deixa de bater e o Git percebe. Como cada commit inclui o hash do pai, alterar qualquer ponto do passado muda todos os hashes dali em diante.
- Comparação barata. Para saber se duas pastas são iguais, basta comparar o hash das trees, sem ler um único arquivo.
O SHA-1 deixou de ser considerado seguro contra ataques deliberados, e o Git reagiu em duas frentes: passou a usar uma versão do SHA-1 que detecta as colisões conhecidas e ganhou suporte a repositórios com SHA-256. A transição do ecossistema para o novo formato ainda está em andamento, mas o modelo é exatamente o mesmo, só muda a função de hash.
Packfiles: como tanta foto cabe em pouco espaço
Quando um objeto é criado, ele é gravado comprimido (com zlib) num arquivo próprio dentro de .git/objects. De tempos em tempos, e sempre que você envia ou recebe dados de um remoto, o Git agrupa os objetos em packfiles: arquivos únicos em que versões parecidas de um mesmo arquivo são guardadas como uma versão completa mais deltas. Ou seja, o modelo lógico é de fotos completas, mas o armazenamento físico é inteligente. O comando git gc faz essa arrumação manualmente, e o git count-objects -v mostra quanto espaço o repositório ocupa.
Por dentro da pasta .git
Vale abrir a pasta .git de qualquer projeto pelo menos uma vez. Tudo o que o Git sabe sobre o repositório está ali, em arquivos comuns:
| Caminho | O que guarda |
|---|---|
HEAD | para onde o HEAD aponta, em geral ref: refs/heads/main |
config | as configurações deste repositório: remotos, ramos rastreados, opções locais |
objects/ | o banco de objetos: cada objeto solto fica em objects/ce/0136…, com os dois primeiros caracteres do hash como pasta, e os packfiles ficam em objects/pack/ |
refs/heads/ | um arquivo por ramo local, com o hash do commit da ponta |
refs/tags/ | um arquivo por tag |
refs/remotes/ | os ramos de rastreamento remoto, como origin/main |
packed-refs | muitas referências agrupadas num arquivo só, para repositórios com milhares de ramos e tags |
index | o índice, o rascunho binário do próximo commit |
logs/ | o reflog: o histórico de por onde cada ramo e o HEAD passaram |
hooks/ | os scripts que o Git executa em momentos definidos (vêm só com exemplos) |
Apagar a pasta .git transforma o projeto numa pasta comum, sem histórico. Copiar a pasta .git para outro lugar leva o repositório inteiro junto. Não há nenhum banco de dados escondido em outro canto do sistema, e é por isso que um repositório Git pode ser movido, compactado e copiado como qualquer outro conjunto de arquivos.
Reftable: as referências num formato próprio
O desenho de um arquivo por ramo é simples, mas mostra os limites em repositórios com centenas de milhares de referências. A documentação do Git cita repositórios como o do Android, com 866 mil referências: o packed-refs vira um arquivo de dezenas de megabytes, procurar uma referência exige percorrê-lo, e um push que muda só dois ramos pode obrigar a reescrevê-lo inteiro. Cada ramo solto ainda ocupa um arquivo próprio no disco, e o reflog, outro.
O reftable, integrado ao Git na versão 2.45, guarda as referências e os reflogs em tabelas binárias ordenadas, com índice, empilhadas uma sobre a outra. Uma atualização grava uma tabela pequena nova no topo da pilha, com custo proporcional ao que mudou, e a busca de uma referência leva tempo quase constante, mesmo com centenas de milhares delas. Para o uso diário, nada muda: os mesmos comandos, os mesmos nomes de ramos. A diferença é que a pasta refs/ deixa de ser a fonte da verdade, e ler ou editar arquivos de referência à mão, um hábito de alguns scripts antigos, deixa de funcionar. Os comandos de encanamento, como git for-each-ref e git update-ref, funcionam com os dois formatos e são o caminho certo para scripts.
Um repositório existente pode ser convertido com git refs migrate --ref-format=reftable, que aceita --dry-run para conferir o resultado antes. A própria documentação lista as limitações atuais: repositórios com worktrees não podem ser migrados, e nada impede que outro processo escreva no repositório durante a conversão, então as escritas precisam ser paradas antes.
As três áreas: trabalho, índice e repositório
Com os objetos em mente, fica fácil entender o fluxo do dia a dia. Os arquivos que você edita passam por três lugares antes de virarem histórico:
- Diretório de trabalho: os arquivos no disco, que você vê e edita no editor.
- Índice, também chamado de staging area: um arquivo binário (
.git/index) que representa o próximo commit, montado aos poucos. - Repositório: os commits já gravados, imutáveis, dentro de
.git.
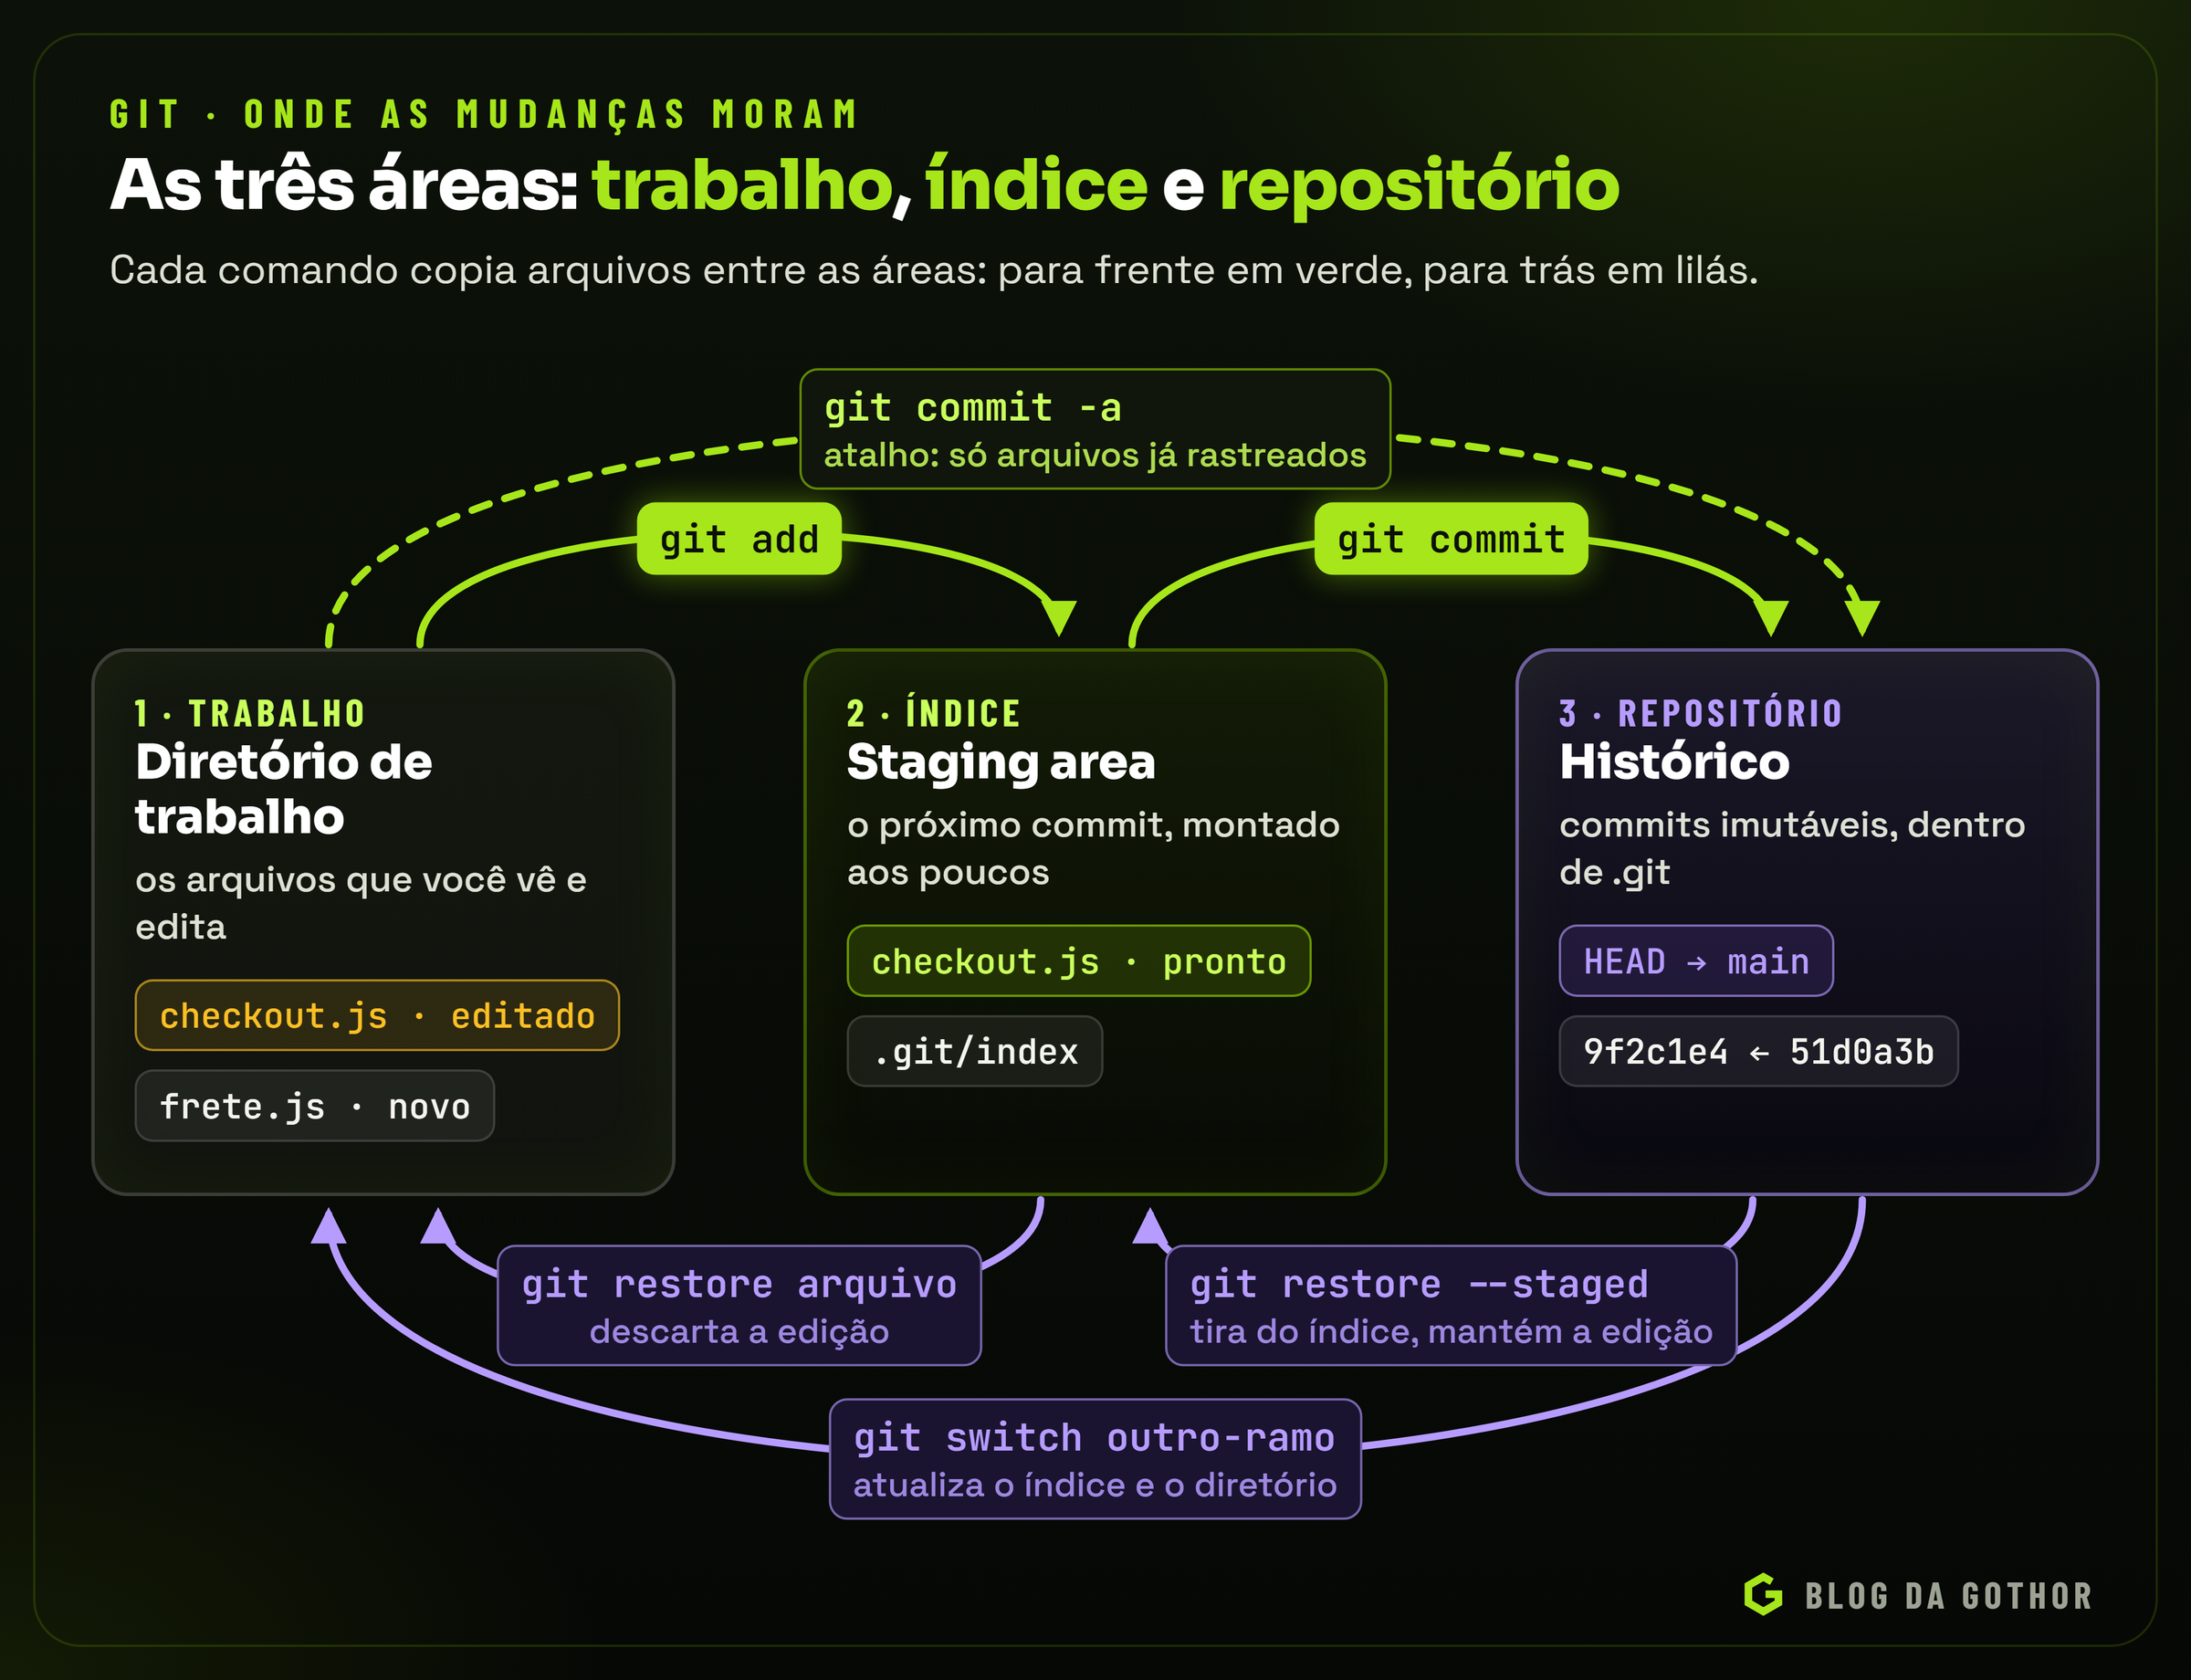
O índice é o que mais confunde quem vem de outras ferramentas, e é também o que dá ao Git a sua flexibilidade. Ele permite que você edite dez arquivos e faça dois commits separados e coerentes, cada um com uma parte das mudanças. Com git add -p, dá para escolher até trechos de um mesmo arquivo:
git status                 # o que mudou no diretório e o que já está no índice
git diff                   # diferenças entre o diretório de trabalho e o índice
git diff --staged          # diferenças entre o índice e o último commit
git add -p src/frete.js    # escolhe, trecho a trecho, o que entra no próximo commit
git commit -m "Calcula o frete por CEP"
Os comandos de volta seguem a mesma lógica. git restore arquivo copia a versão do índice para o diretório de trabalho, descartando a edição. git restore --staged arquivo copia a versão do último commit para o índice, ou seja, tira o arquivo do próximo commit sem mexer no que você editou. git switch troca de ramo e atualiza as duas áreas de uma vez. Os comandos switch e restore existem desde 2019 justamente para separar responsabilidades que antes se acumulavam no git checkout, que continua funcionando.
O que o índice guarda de verdade
O índice não guarda o conteúdo dos arquivos: o conteúdo já virou blob no banco de objetos no momento do git add. O que o arquivo .git/index guarda é uma lista ordenada de caminhos, e para cada caminho o modo (arquivo comum, executável ou link simbólico), o hash do blob e um punhado de dados do sistema de arquivos, como o tamanho e a data da última modificação.
Esses dados do sistema de arquivos são o segredo da velocidade do git status. Para saber se um arquivo mudou, o Git primeiro compara o tamanho e a data gravados no índice com os do disco. Se forem iguais, o arquivo é considerado intacto, sem ler um byte do conteúdo. Só os arquivos com data ou tamanho diferentes têm o hash recalculado. Num projeto com dezenas de milhares de arquivos, é a diferença entre um status instantâneo e um que leva segundos.
Dá para ver o índice com um comando de encanamento:
$ git ls-files --stage
100644 955be2c96a48dcc1d8a71fb48210a635415868a0 0	README.md
100644 c47e1b0… 0	src/frete.js
O número antes do caminho é o estágio. Em situação normal ele é sempre 0. Durante um conflito de merge, o mesmo caminho aparece três vezes: no estágio 1, a versão do ancestral comum; no 2, a sua versão; no 3, a versão do outro lado. É assim que o Git sabe que um arquivo está em conflito, e é por isso que o git add depois da resolução "resolve" o conflito: ele substitui as três entradas por uma só, no estágio 0.
Arquivos ignorados: as regras do .gitignore
Todo arquivo do diretório de trabalho que não está no índice é "não rastreado", e o .gitignore diz quais deles o Git deve fingir que não vê. As regras parecem óbvias até a primeira surpresa:
# qualquer arquivo .log, em qualquer pasta
*.log
# só a pasta build na raiz do projeto (a barra do começo ancora o padrão)
/build/
# a pasta node_modules em qualquer nível (a barra do fim vale só para pastas)
node_modules/
# todos os .env, menos o modelo, que deve ser versionado
.env*
!.env.exemplo
# tudo dentro de relatorios, em qualquer profundidade
relatorios/**
Três regras explicam quase todas as dúvidas. A primeira: dentro de um mesmo arquivo, vale o último padrão que combina, e por isso a exceção com ! vem depois da regra geral. A segunda: não dá para reincluir um arquivo se a pasta dele foi ignorada. Com logs/ no .gitignore, um !logs/importante.log não tem efeito, porque o Git nem entra na pasta; o certo é ignorar o conteúdo, logs/*, e então abrir a exceção. A terceira: **o .gitignore não afeta arquivos já rastreados**. Se um .env foi commitado antes de entrar na lista, ele continua no histórico e continua sendo acompanhado; tirá-lo exige git rm --cached .env, e, se continha segredos, trocá-los.
As regras vêm de mais de um lugar, em ordem de prioridade: os padrões passados na linha de comando, os .gitignore de cada pasta (o mais profundo vence), o arquivo .git/info/exclude, que vale só para a sua cópia e não é versionado, e o arquivo global apontado por core.excludesFile, bom para os rastros do seu editor e do seu sistema operacional, que não dizem respeito ao projeto. Quando um arquivo some do git status sem motivo aparente, git check-ignore -v caminho mostra qual arquivo e qual linha o estão ignorando.
Do zero ao primeiro commit, passo a passo
Com o modelo na cabeça, vale acompanhar o que acontece por dentro quando um repositório nasce. O exemplo usa uma pasta vazia e comandos que funcionam em qualquer sistema.
1. Criar o repositório. O git init cria a pasta .git com a estrutura vista acima, ainda sem nenhum objeto:
$ mkdir loja && cd loja
$ git init
Initialized empty Git repository in /home/ana/loja/.git/
$ find .git/objects -type f | wc -l
0
2. Escrever um arquivo. Criar README.md não muda nada dentro de .git. O arquivo existe só no diretório de trabalho, e o git status o mostra como "não rastreado" (untracked).
3. Adicionar ao índice. É aqui que o primeiro objeto nasce. O git add calcula o hash do conteúdo, grava o blob comprimido em .git/objects e registra o caminho no índice:
$ echo '# Loja virtual' > README.md
$ git add README.md
$ find .git/objects -type f
.git/objects/95/5be2c96a48dcc1d8a71fb48210a635415868a0
$ git cat-file -t 955be2c
blob
Se você repetir o exemplo com o mesmo texto, o hash do blob será exatamente esse, porque ele depende só do conteúdo. Já o hash do commit, no passo seguinte, será outro na sua máquina, porque inclui o seu nome e a data.
4. Fazer o commit. O git commit faz três coisas em sequência. Primeiro, transforma o índice em trees, uma por pasta, e grava cada uma como objeto. Depois, cria o objeto commit, com o hash da tree raiz, o autor, a data, a mensagem e, como é o primeiro, nenhum pai. Por fim, grava o hash do commit novo no arquivo do ramo atual, .git/refs/heads/main, que até então não existia:
$ git commit -m "Cria a loja"
[main (root-commit) 86ce556] Cria a loja
 1 file changed, 1 insertion(+)
$ find .git/objects -type f | wc -l
3
Três objetos: o blob do README.md, a tree da raiz e o commit. A expressão root-commit na saída indica justamente o commit sem pai.
5. Mudar e commitar de novo. Ao editar o README.md e repetir o ciclo, nascem um blob novo, uma tree nova (porque o hash do arquivo mudou) e um commit novo, que aponta para o anterior como pai. Um arquivo que não tivesse mudado seria reaproveitado: a tree nova apontaria para o mesmo blob de antes.
Esse passo a passo explica por que o Git é tão rápido para criar commits: nenhuma cópia de arquivo inteiro é feita além dos que mudaram, e o commit em si é um objeto de poucas centenas de bytes. Também explica por que o git add importa: o momento em que o conteúdo é "fotografado" é o add, e não o commit. Se você editar um arquivo depois do add e não adicioná-lo de novo, o commit leva a versão antiga, a que estava no índice.
Ramos, HEAD e o grafo de commits
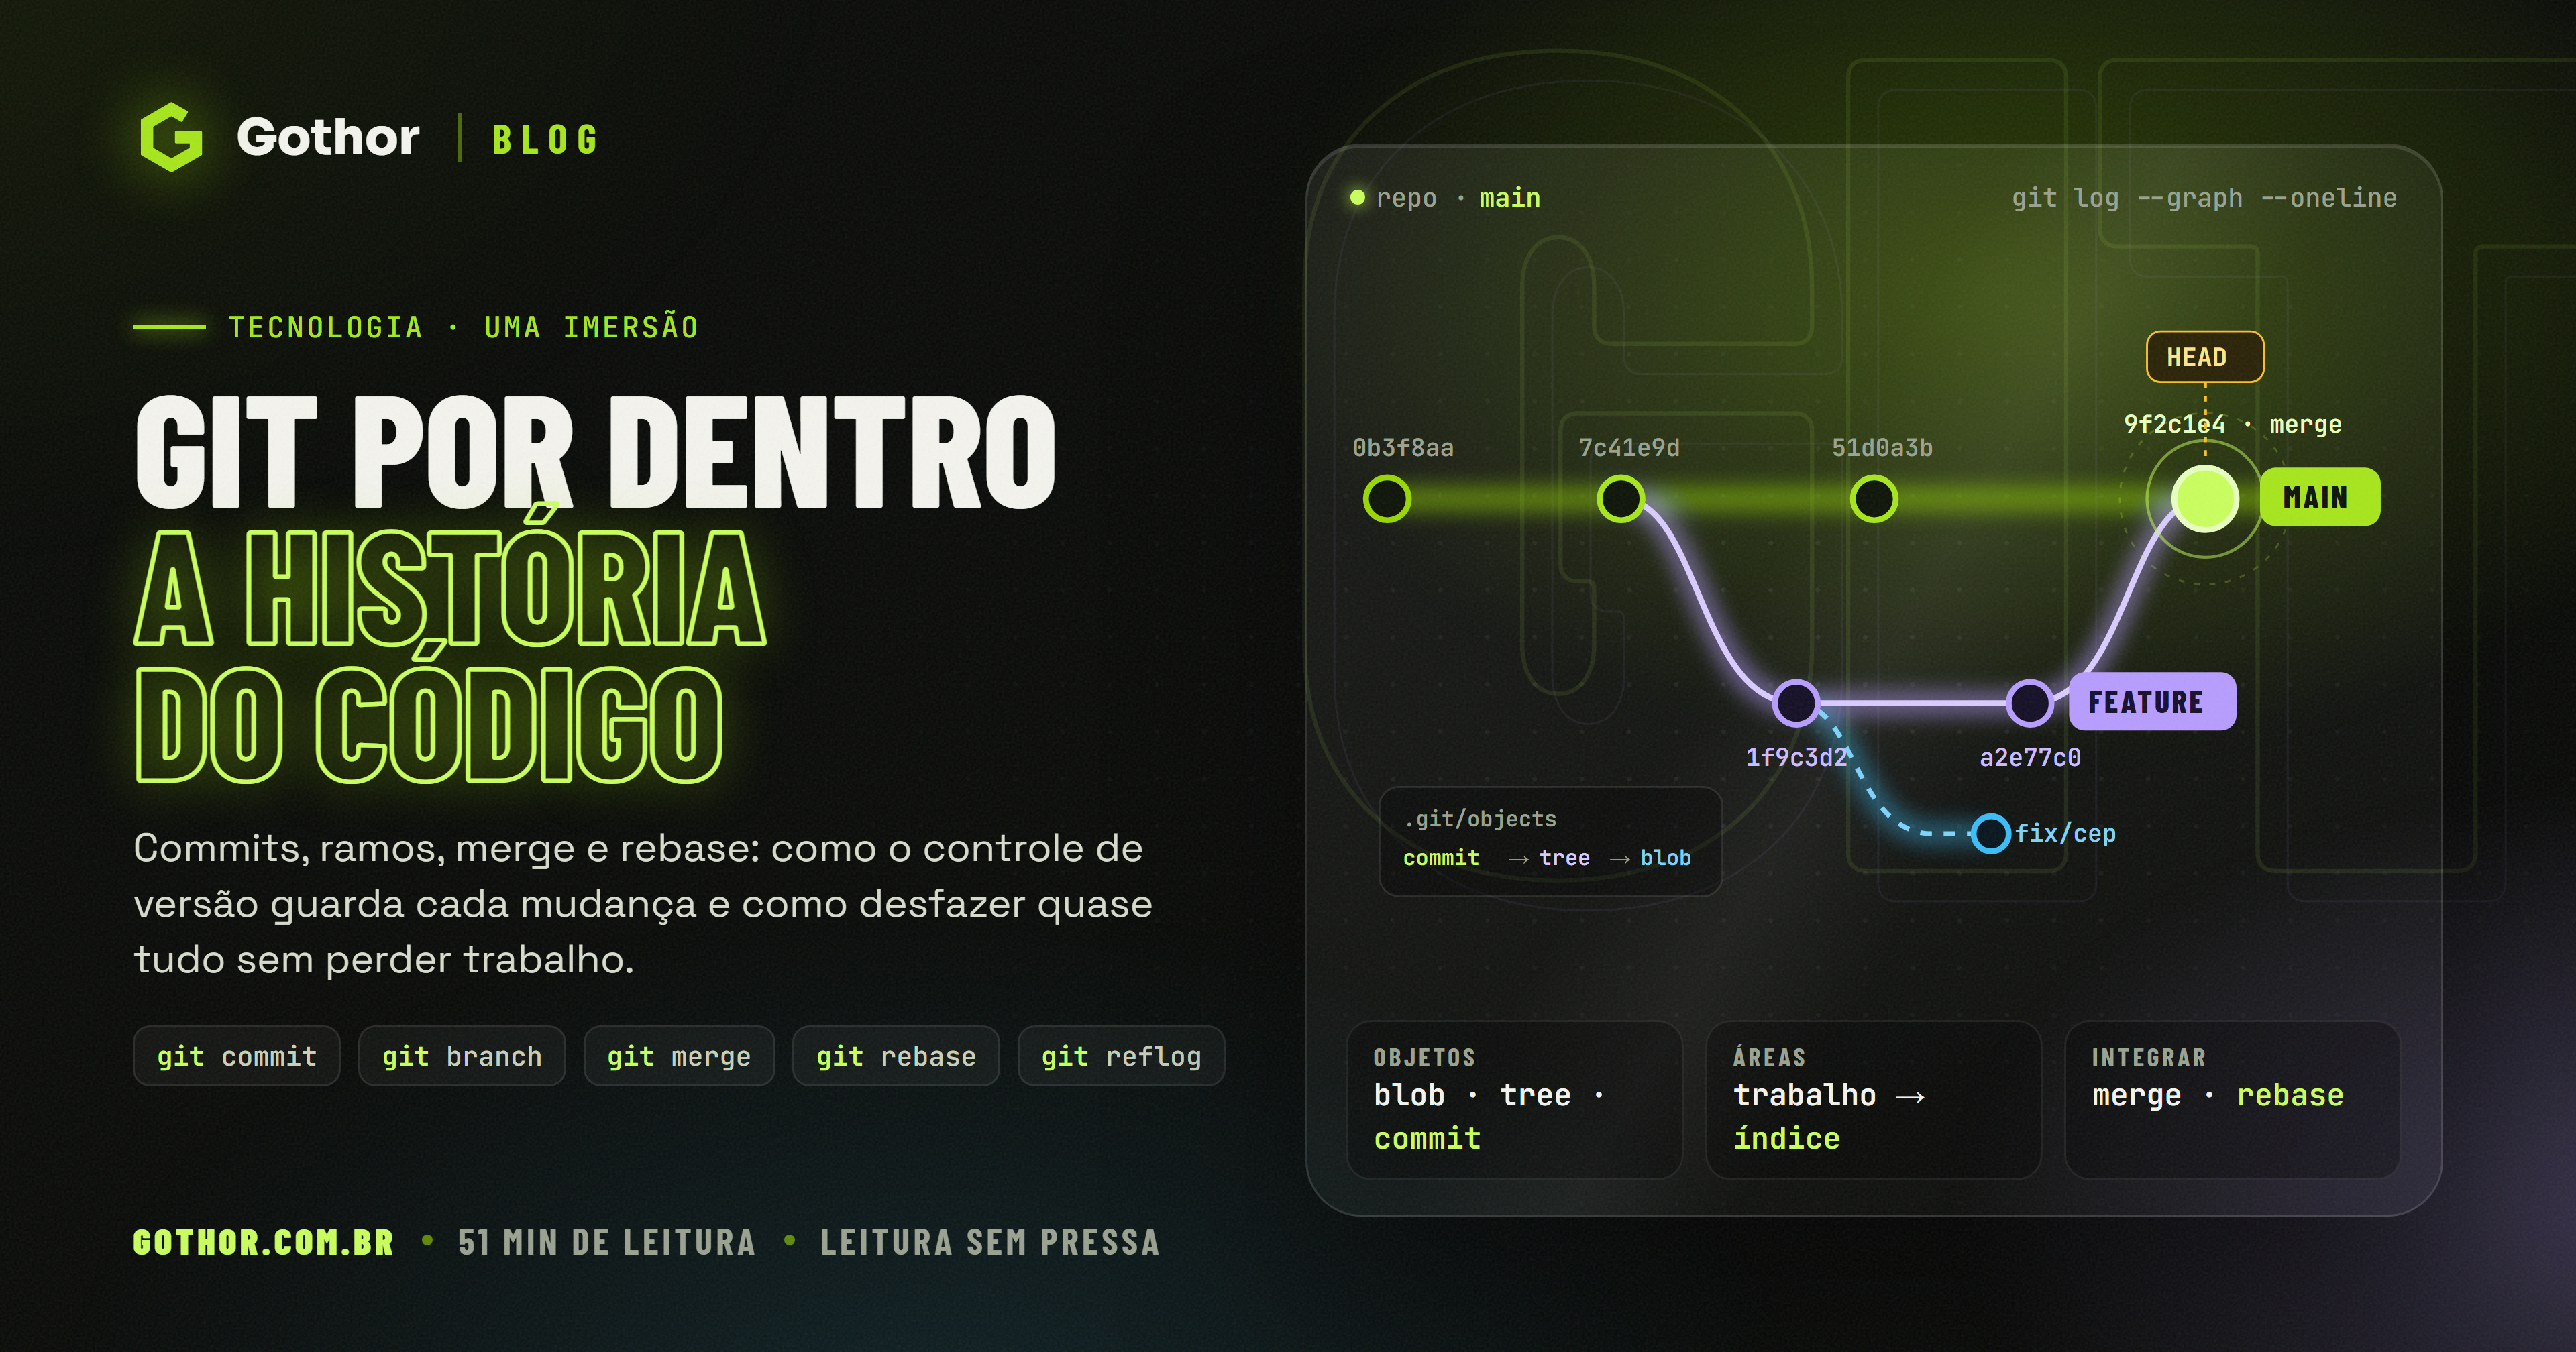
Como cada commit aponta para o seu pai, o histórico forma uma cadeia. Quando dois commits têm o mesmo pai, a cadeia se divide; quando um commit tem dois pais, ela se junta. O resultado é um grafo acíclico dirigido, que é a forma técnica de dizer "uma árvore que pode se dividir e se juntar, mas nunca andar em círculo".
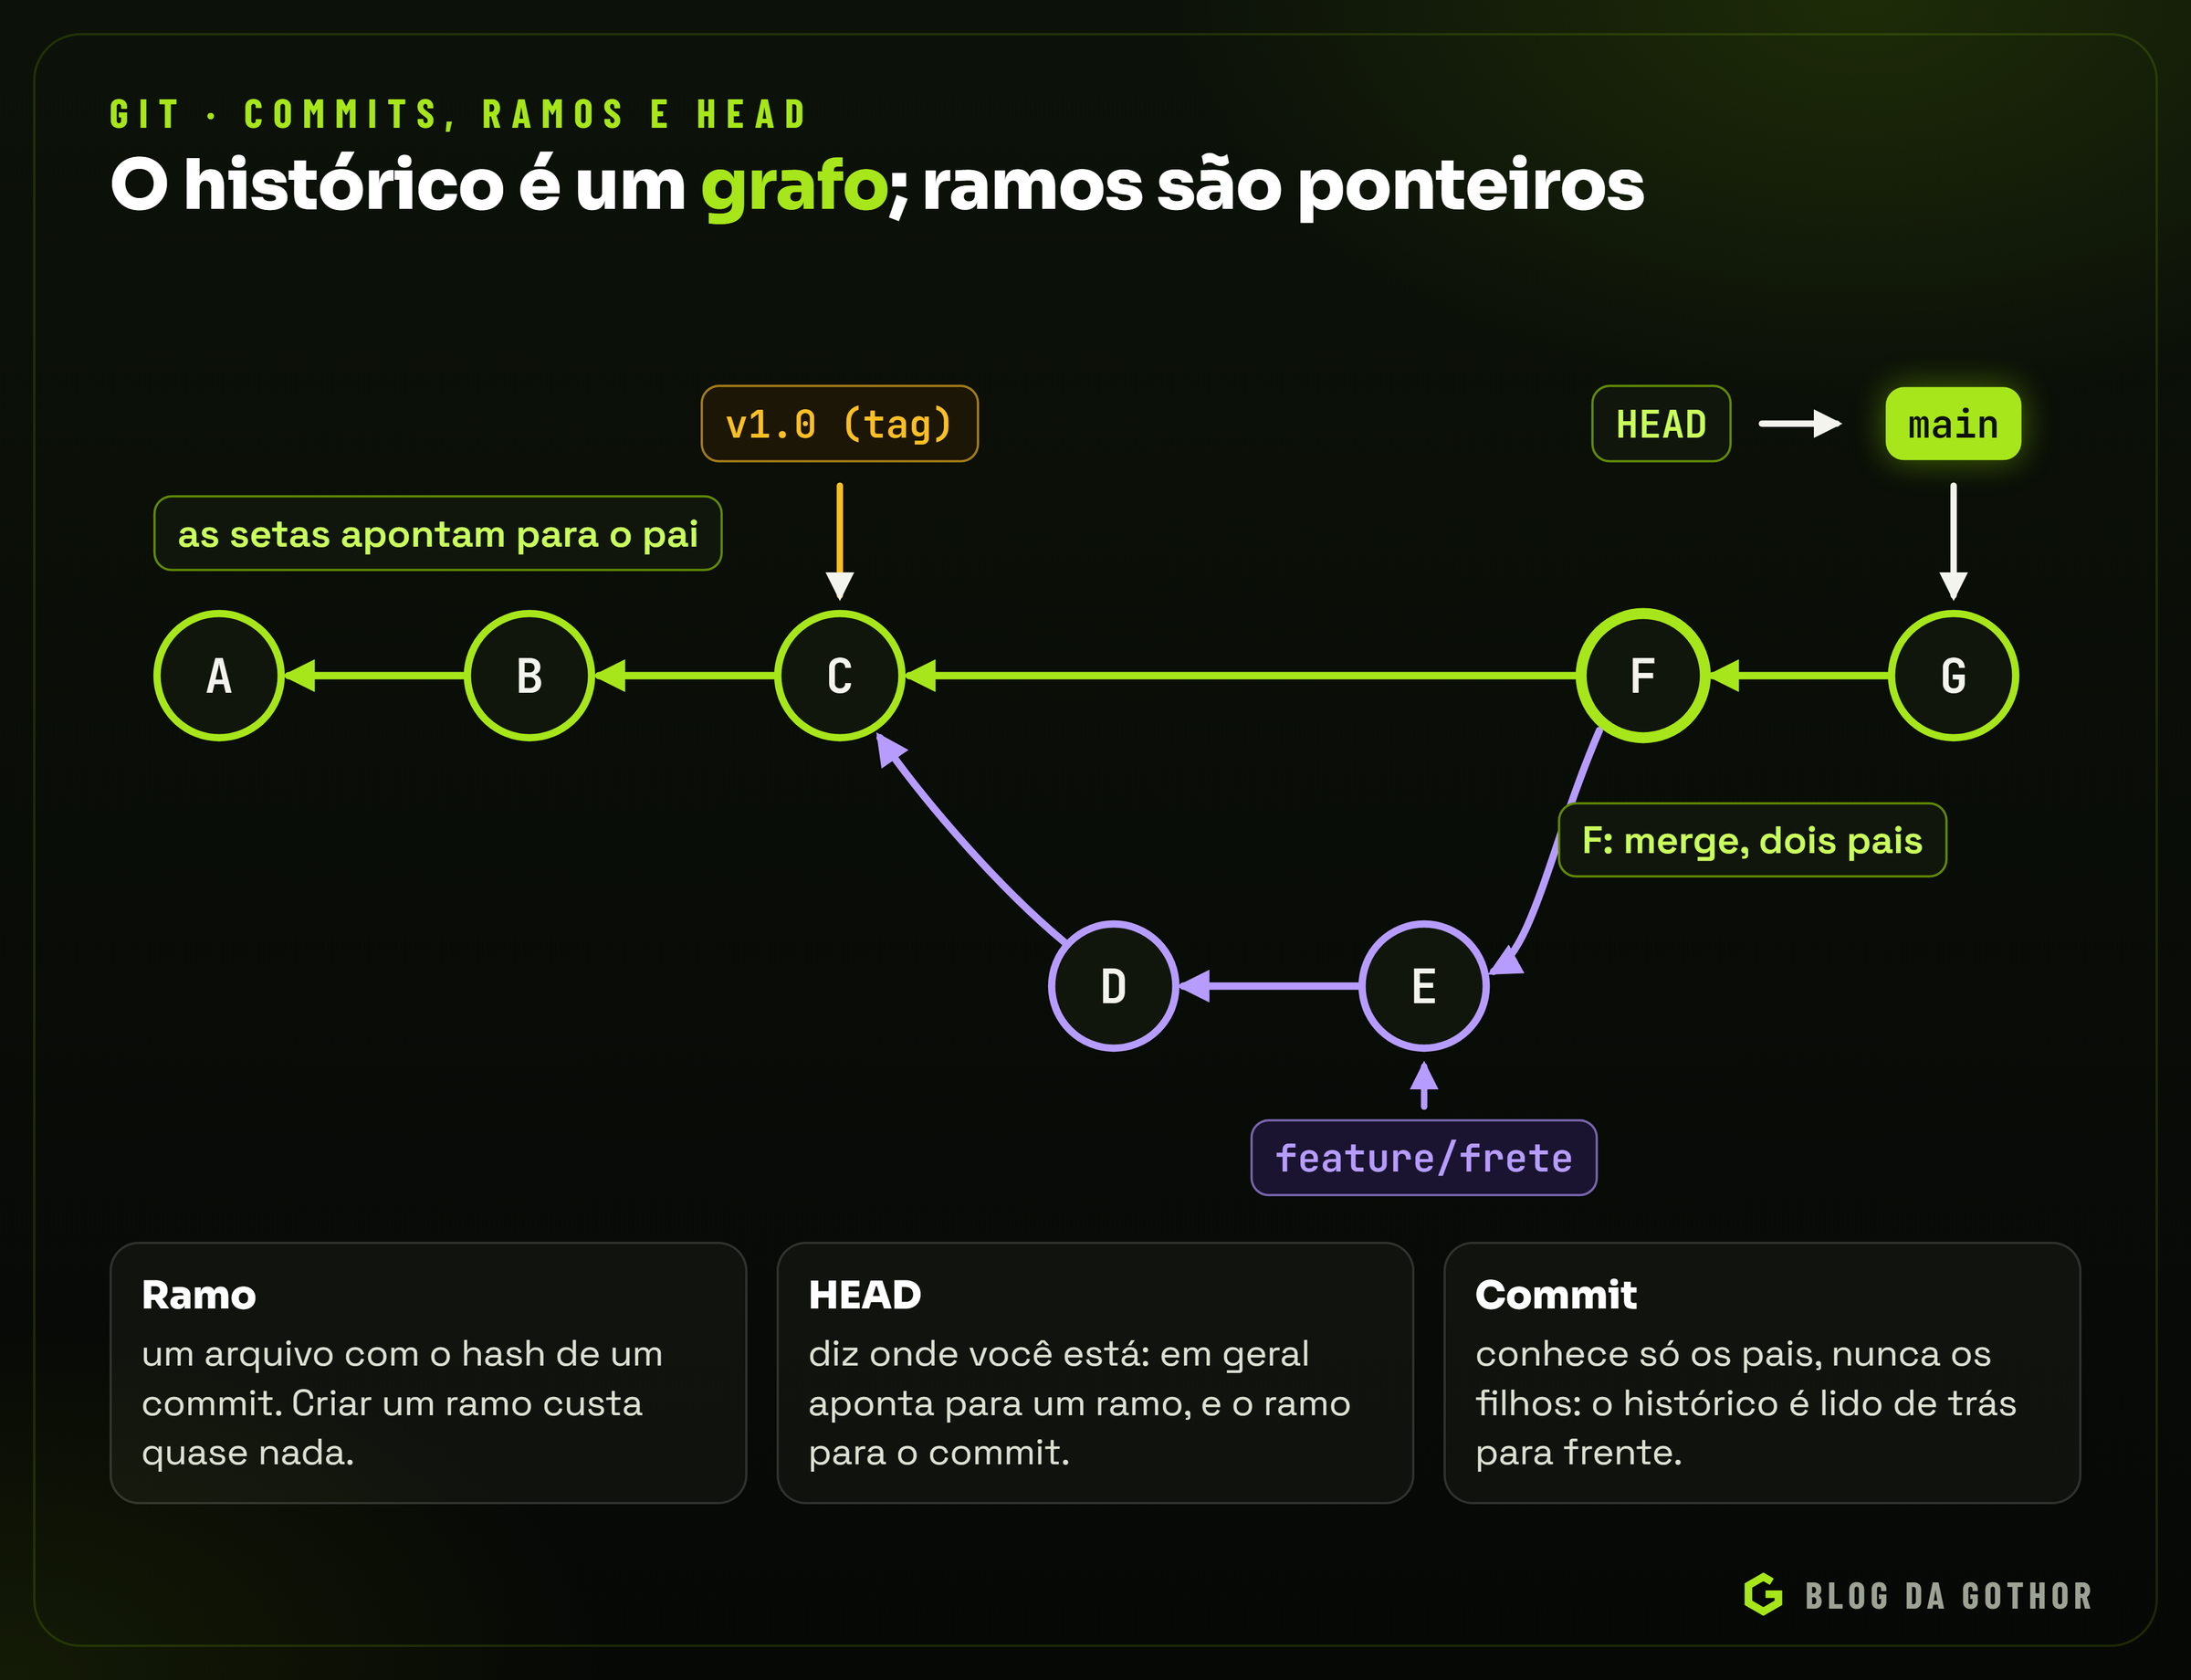
Nesse grafo, um ramo (branch) é surpreendentemente simples: é um arquivo de texto com o hash de um commit. No repositório de exemplo:
$ cat .git/HEAD
ref: refs/heads/main

$ cat .git/refs/heads/main
86ce5566c75b782e4aa762fee0a4b6a73fb50072
É só isso. Na forma mais simples, criar um ramo é criar um arquivo de 41 bytes (o Git também pode agrupar essas referências num arquivo só, mas a ideia é a mesma); por isso é instantâneo, e por isso o Git incentiva criar ramos para qualquer tarefa, por menor que seja. Quando você faz um commit, o Git grava os objetos e move o ponteiro do ramo atual para o commit novo.
O HEAD é o ponteiro que diz onde você está. Em geral ele aponta para um ramo, que aponta para um commit. Se você fizer git switch --detach para um commit específico, o HEAD passa a apontar diretamente para o commit, no estado chamado de detached HEAD. Não há nada de errado nisso para inspecionar uma versão antiga; o cuidado é que commits feitos nesse estado não pertencem a nenhum ramo e podem ficar esquecidos.
As tags são ponteiros que não andam. Uma tag v1.0 marca para sempre o commit que foi para produção naquela versão, o que facilita voltar exatamente àquele estado.
Criar, trocar e apagar ramos
git switch -c feature/frete     # cria o ramo a partir de onde você está e muda para ele
git switch main                 # volta para a main
git branch                      # lista os ramos locais
git branch -d feature/frete     # apaga o ramo (só se já foi integrado)
git log --oneline --graph --all # desenha o grafo no terminal
Um detalhe que ajuda muito a ler o histórico: um commit conhece os pais, mas nunca os filhos. Por isso o git log sempre anda de trás para frente, a partir de um ponteiro. Commits que nenhum ramo, tag ou HEAD alcança são considerados inacessíveis e, depois de um tempo, são removidos pela coleta de lixo.
Como apontar para um commit: a sintaxe das revisões
Quase todo comando do Git aceita uma "revisão", que é qualquer expressão que leve a um commit. Escrever hashes inteiros seria impraticável, então o Git tem uma pequena linguagem para isso, e conhecê-la muda a forma de trabalhar no terminal:
| Expressão | Significa |
|---|---|
86ce556 | um commit pelo início do hash; bastam os caracteres necessários para não haver ambiguidade |
HEAD~1 ou HEAD~ | o pai do commit atual; HEAD~3 é o bisavô, sempre seguindo o primeiro pai |
HEAD^2 | o segundo pai de um commit de merge, ou seja, a ponta do ramo que foi integrado |
main@{1} | onde a main estava antes do último movimento, segundo o reflog |
main@{yesterday} | onde a main estava ontem, também pelo reflog local (o Git entende expressões de data em inglês, como 2.days.ago) |
@{u} | o ramo remoto que o ramo atual acompanha, como origin/main |
main..feature | os commits que estão em feature e não estão em main |
main...feature | os commits que estão em um dos dois lados, mas não em ambos |
HEAD:src/frete.js | o arquivo src/frete.js como estava no commit atual |
:/frete | o commit mais recente cuja mensagem contém "frete" |
Com isso, perguntas comuns viram comandos de uma linha. "O que o meu ramo tem que a main ainda não tem?" é git log --oneline main..HEAD. "O que chegou no remoto desde o meu último pull?" é git log HEAD..@{u}, depois de um fetch. "Como estava este arquivo duas versões atrás?" é git show HEAD~2:src/frete.js.
Integrar trabalho: merge e rebase
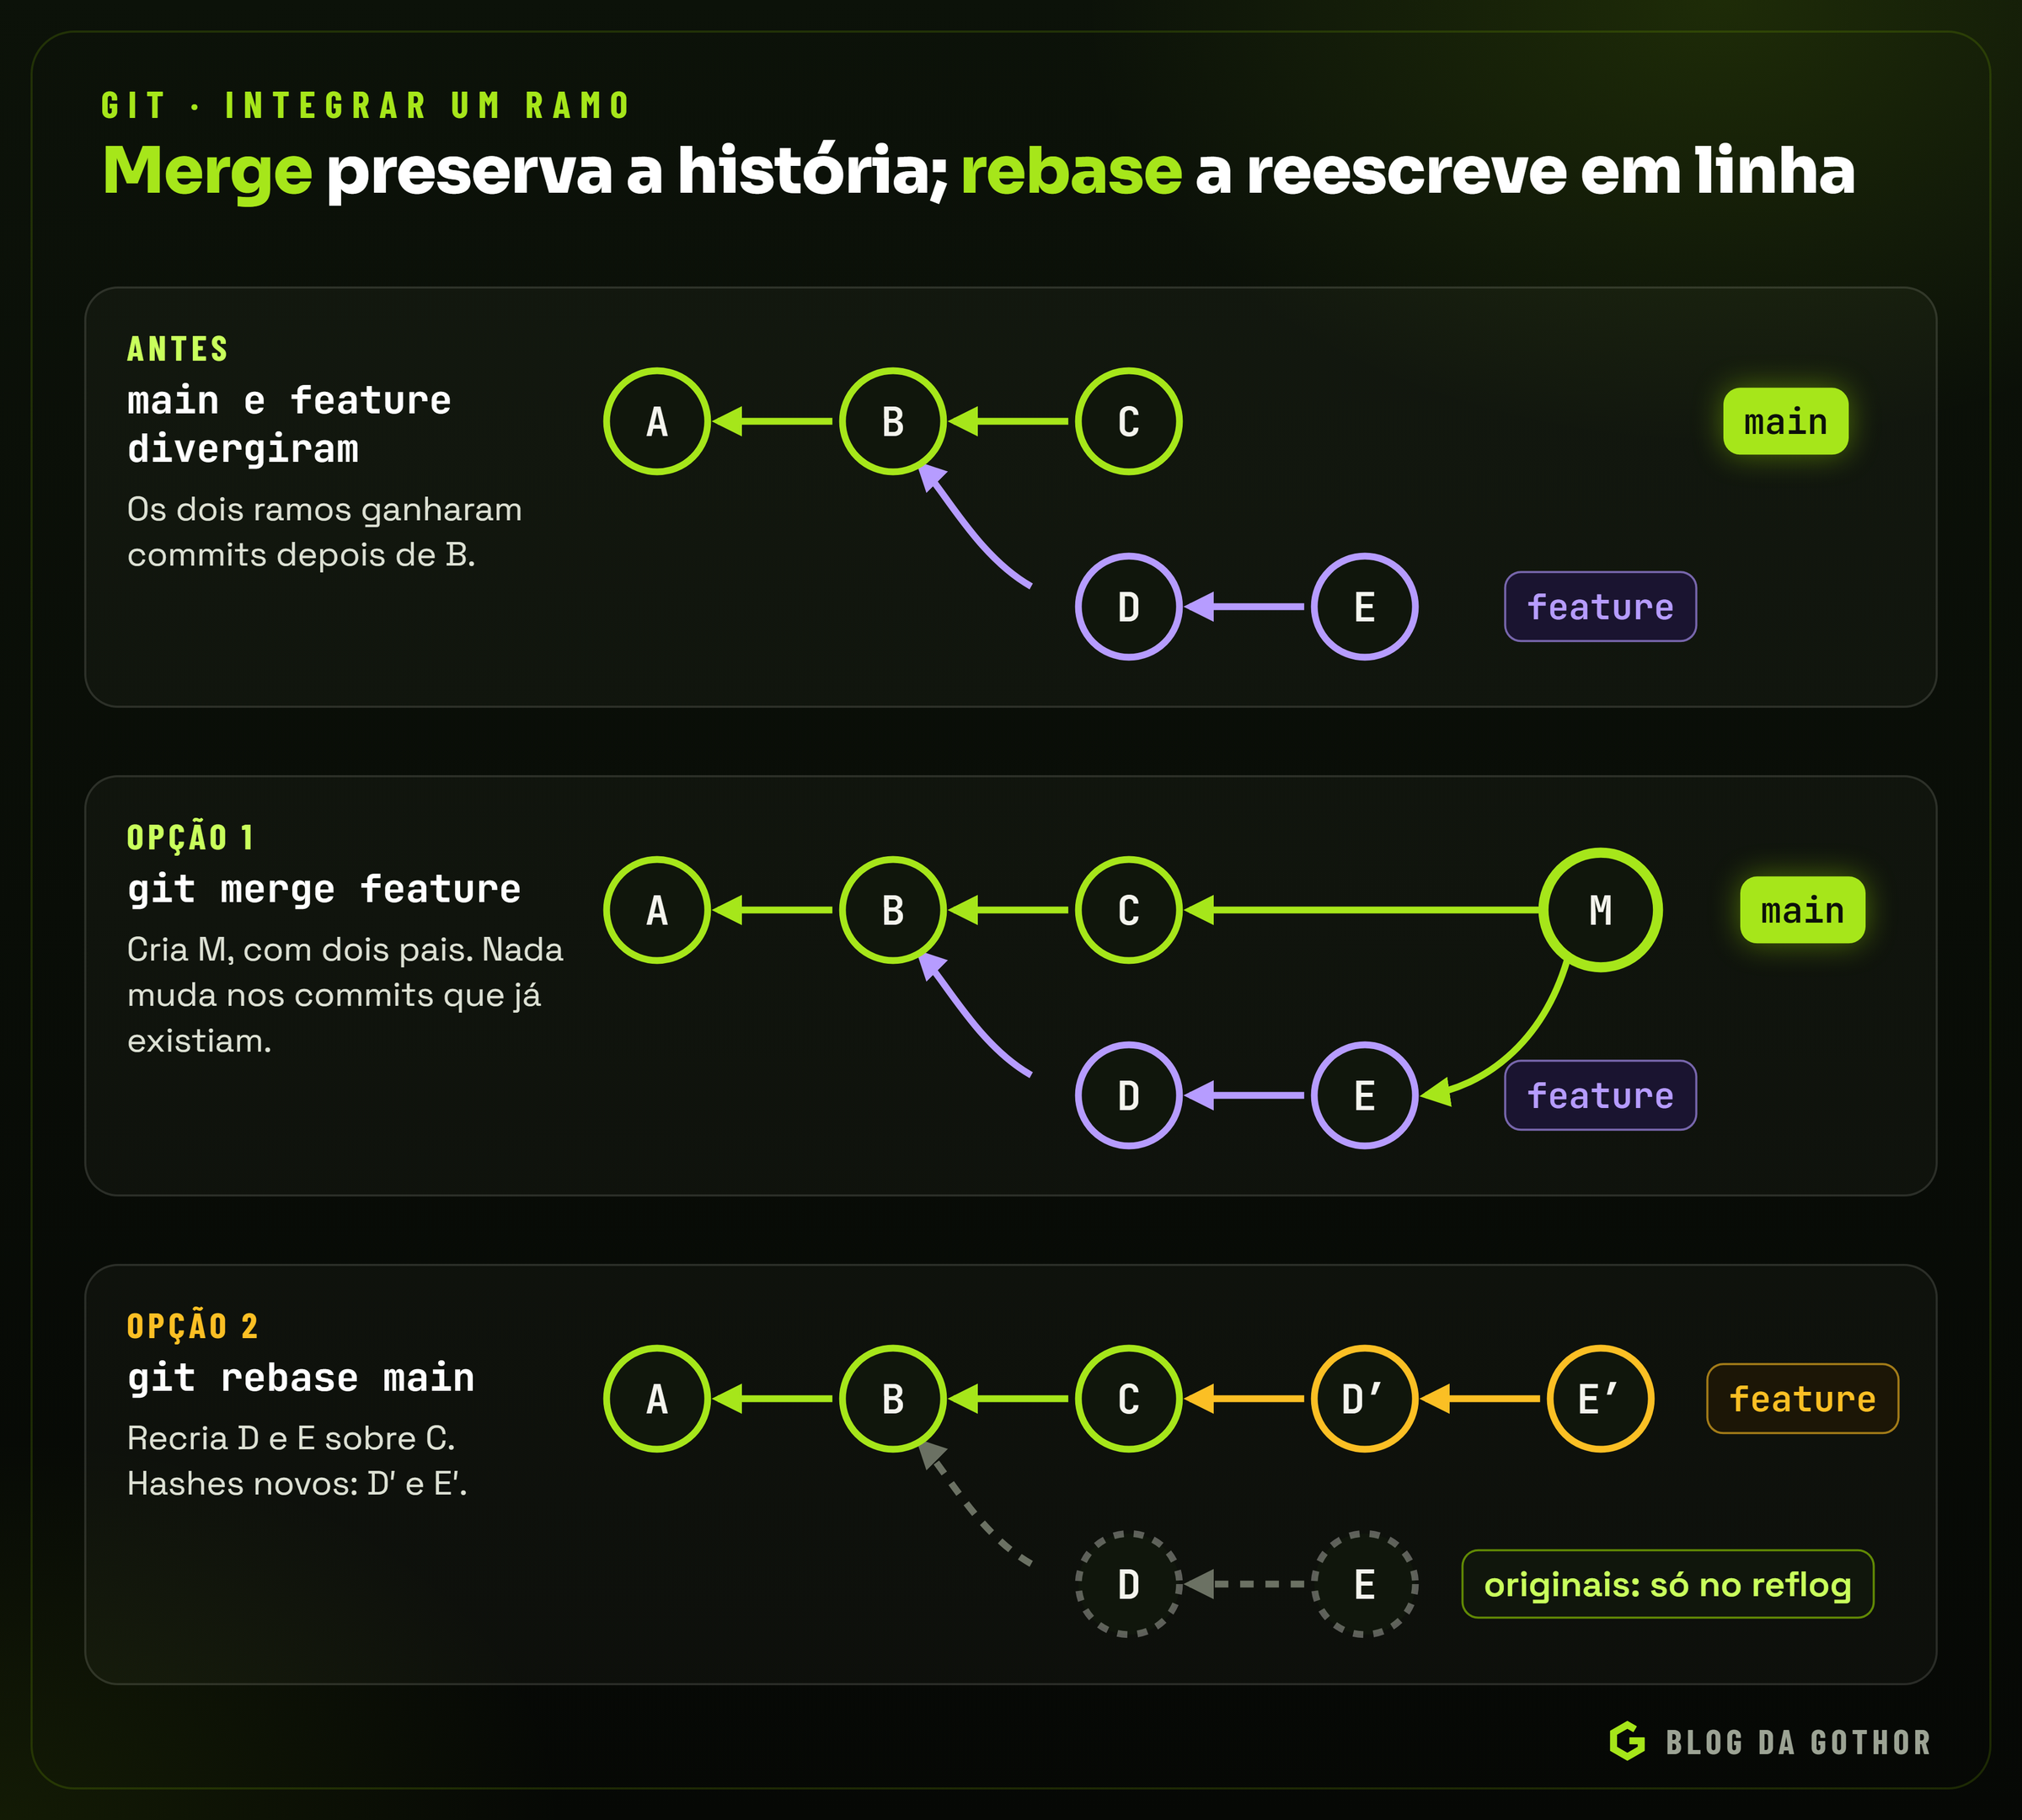
Ramos só têm valor se puderem voltar a se juntar. O Git oferece duas formas de integrar o trabalho de um ramo em outro, e entender a diferença entre elas evita boa parte dos problemas de equipe.
Merge
O git merge junta dois históricos. Há dois casos:
- Fast-forward: se a
mainnão andou desde que o ramo foi criado, não há nada para combinar. O Git simplesmente avança o ponteiro damainaté o último commit do ramo. - Merge de três vias: se os dois lados andaram, o Git encontra o ancestral comum (a merge base), compara cada lado com ele e combina as mudanças, criando um commit de merge com dois pais. Desde a versão 2.34, a estratégia padrão para isso se chama
ort, mais rápida e previsível que a antigarecursive.
O merge não altera nenhum commit existente. Ele só acrescenta. Isso o torna seguro para ramos compartilhados e preserva a história como ela de fato aconteceu, com o custo de um grafo mais ramificado.
O merge de três vias, passo a passo
Por que o Git precisa do ancestral comum? Porque, sem ele, é impossível saber quem mudou o quê. Imagine que, na main, uma linha diz taxa = 12 e, no ramo, diz taxa = 15. Comparando só os dois lados, não há como saber se a main baixou de 15 para 12 ou se o ramo subiu de 12 para 15. Com o ancestral comum na mão, a resposta é imediata: se o ancestral dizia taxa = 12, só o ramo mexeu, e o resultado é 15.
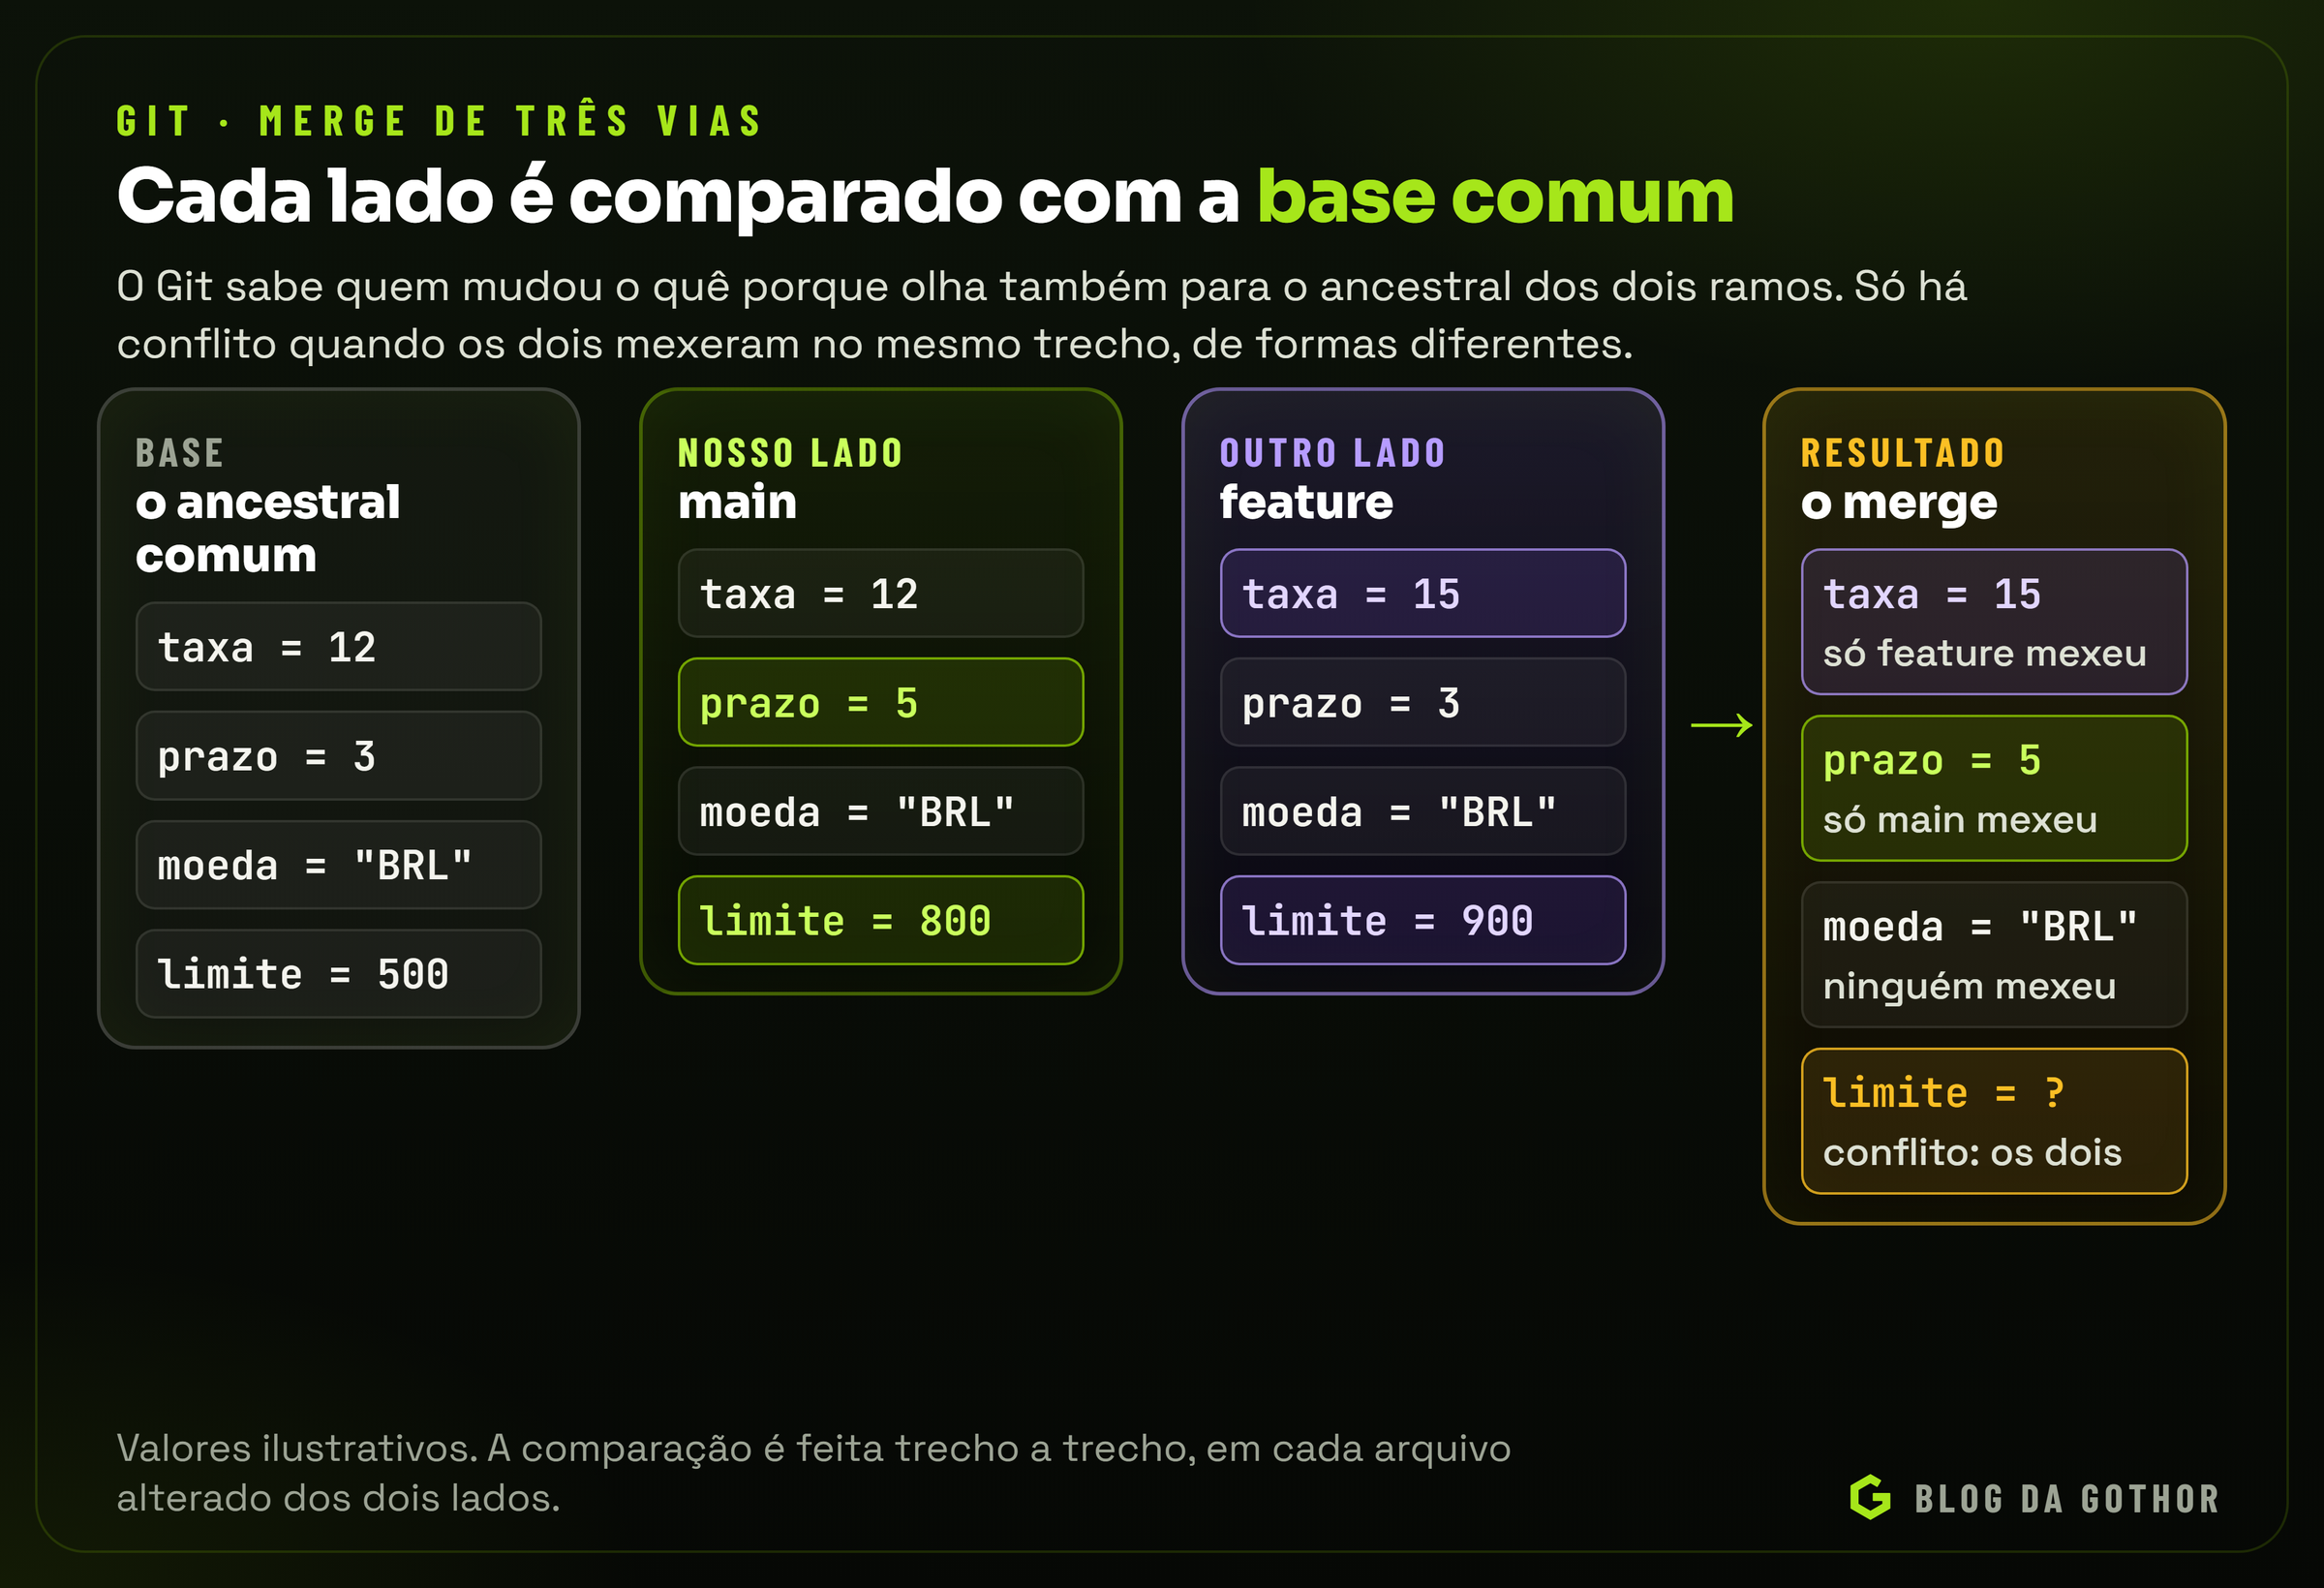
A regra, aplicada trecho a trecho, é simples:
| Base | Nosso lado | Outro lado | Resultado |
|---|---|---|---|
| A | A | A | A, ninguém mexeu |
| A | B | A | B, só o nosso lado mexeu |
| A | A | C | C, só o outro lado mexeu |
| A | B | B | B, os dois fizeram a mesma mudança |
| A | B | C | conflito: os dois mexeram, de formas diferentes |
O processo completo de um git merge feature com a main atual é este:
- O Git calcula a merge base, o commit mais recente que é ancestral dos dois lados (
git merge-base main featuremostra qual é). - Para cada arquivo, compara a versão da base com a da
maine com a defeature. - Arquivos alterados só de um lado são copiados daquele lado, sem olhar o conteúdo.
- Arquivos alterados dos dois lados são combinados trecho a trecho, pela tabela acima.
- Se não houver conflito, o Git monta a tree resultante e cria o commit de merge com dois pais, na ordem: primeiro a
main, depoisfeature. - Se houver conflito, o Git para antes do passo 5, deixa os arquivos marcados e as três versões no índice, e espera a resolução.
A estratégia ort também detecta renomeações: se um lado renomeou frete.js para calculo-frete.js e o outro alterou frete.js, a mudança é aplicada no arquivo com o nome novo. Para isso, o Git compara o conteúdo dos arquivos que sumiram com os que apareceram e considera renomeação quando a semelhança passa de um limite, 50% por padrão.
Quando há mais de um ancestral comum possível, o que acontece em históricos com merges cruzados, a estratégia combina primeiro os ancestrais num ancestral virtual e só então faz o merge de três vias. É por isso que o nome da estratégia antiga era recursive.
Rebase
O git rebase main, executado no ramo de funcionalidade, faz outra coisa: pega os commits do ramo que ainda não estão na main e os reaplica um a um sobre a ponta da main. O resultado é um histórico linear, como se o trabalho tivesse começado depois das últimas mudanças da main.
O ponto essencial é que os commits reaplicados são commits novos, com hashes novos, porque o pai mudou e o hash depende do pai. Os originais continuam existindo por um tempo, alcançáveis só pelo reflog. Daí vem a regra de ouro:
Não faça rebase de commits que outras pessoas já baixaram. Reescrever um histórico publicado obriga todos a reconciliar cópias que não batem mais.
O rebase também tem um modo interativo, git rebase -i, que permite reordenar, juntar (squash), editar ou descartar commits antes de publicar um ramo. É a forma usual de transformar uma sequência de commits de rascunho ("ajuste", "agora vai", "corrige o anterior") em dois ou três commits limpos e revisáveis.
Rebase interativo, passo a passo
Suponha um ramo com quatro commits feitos ao longo de um dia de trabalho, ainda não enviados ao remoto:
$ git log --oneline main..HEAD
e4a1c90 corrige teste
b72d013 ajuste no nome da função
5f30a8e Calcula o frete por CEP
1c9b2d4 Extrai a tabela de faixas de CEP
O comando git rebase -i main abre um editor com a lista dos commits, do mais antigo para o mais novo, cada um precedido de uma ação:
pick 1c9b2d4 Extrai a tabela de faixas de CEP
pick 5f30a8e Calcula o frete por CEP
pick b72d013 ajuste no nome da função
pick e4a1c90 corrige teste
Trocando as palavras do começo de cada linha, você diz o que fazer:
| Ação | Efeito |
|---|---|
pick | mantém o commit como está |
reword | mantém o commit e abre o editor para mudar a mensagem |
edit | para nesse commit, para você alterá-lo antes de seguir |
squash | junta o commit ao anterior e deixa você combinar as mensagens |
fixup | junta o commit ao anterior e descarta a mensagem dele |
drop | remove o commit |
Para o exemplo, basta mudar as duas últimas linhas para fixup. Ao salvar, o Git reaplica os commits na ordem, junta os dois ajustes ao commit "Calcula o frete por CEP" e o ramo fica com dois commits coesos. Também é possível mudar a ordem das linhas para reordenar os commits, desde que um não dependa do outro.
Há um atalho que vale adotar. Ao corrigir algo de um commit anterior, em vez de "corrige teste", faça git commit --fixup 5f30a8e. O Git cria um commit com a mensagem "fixup! Calcula o frete por CEP", e um git rebase -i --autosquash main já monta a lista com esse commit na posição certa e com a ação fixup marcada. Com git config --global rebase.autoSquash true, o comportamento vira padrão.
Se algo der errado no meio do caminho, git rebase --abort devolve o ramo exatamente ao estado anterior. E, depois de concluído, o estado antigo continua acessível pelo reflog, como feature@{1}, por algumas semanas.
Conflitos sem drama
Um conflito acontece quando os dois lados alteraram o mesmo trecho de forma diferente e o Git não tem como decidir sozinho. Ele para, marca o arquivo e espera você:
export function frete(cep) {
<<<<<<< HEAD
  return cep.startsWith("78") ? 15 : 30;
=======
  return cep.startsWith("78") ? 12 : 30;
>>>>>>> feature/frete
}
Entre <<<<<<< e ======= está a versão do lado em que você está; entre ======= e >>>>>>>, a do outro lado. Resolver é editar o arquivo até ele ficar como deve ser, apagar os marcadores, rodar os testes e concluir com git add e git commit (num merge) ou git rebase --continue (num rebase). Se a situação ficar confusa, git merge --abort ou git rebase --abort voltam tudo ao estado anterior. Para conflitos que se repetem, a opção rerere ("reuse recorded resolution") faz o Git lembrar como você resolveu e reaplicar a solução.
Conflitos frequentes quase sempre indicam ramos que vivem tempo demais. Integrar com mais frequência, em pedaços menores, é o melhor remédio.
Quando usar cada um
| Situação | Melhor escolha | Por quê |
|---|---|---|
Atualizar o seu ramo local com a main | rebase | mantém o seu trabalho linear e fácil de revisar |
Integrar um ramo revisado na main | merge (ou squash, se a equipe preferir) | não reescreve nada que já foi publicado |
| Limpar commits de rascunho antes de abrir o pull request | rebase interativo | a revisão fica mais clara |
| Ramo que outras pessoas já baixaram | merge | o rebase obrigaria todos a reconciliar cópias |
| Corrigir a mensagem do último commit, ainda local | commit --amend | recria só o último commit |
Trabalho em equipe: remotos, fetch, pull e push
Um remoto é outra cópia do mesmo repositório, normalmente num servidor como o GitHub. Por convenção, o remoto de onde você clonou se chama origin. Os comandos de sincronização são poucos, e cada um tem uma direção:
git clonecopia um repositório inteiro, com todo o histórico, na primeira vez.git fetchbusca os commits novos do remoto e atualiza os ramos de rastreamento remoto, comoorigin/main. Não mexe nos seus ramos nem nos seus arquivos.git pullé umfetchseguido de uma integração (merge ou rebase) no ramo atual.git pushenvia os seus commits e move o ramo correspondente no remoto.
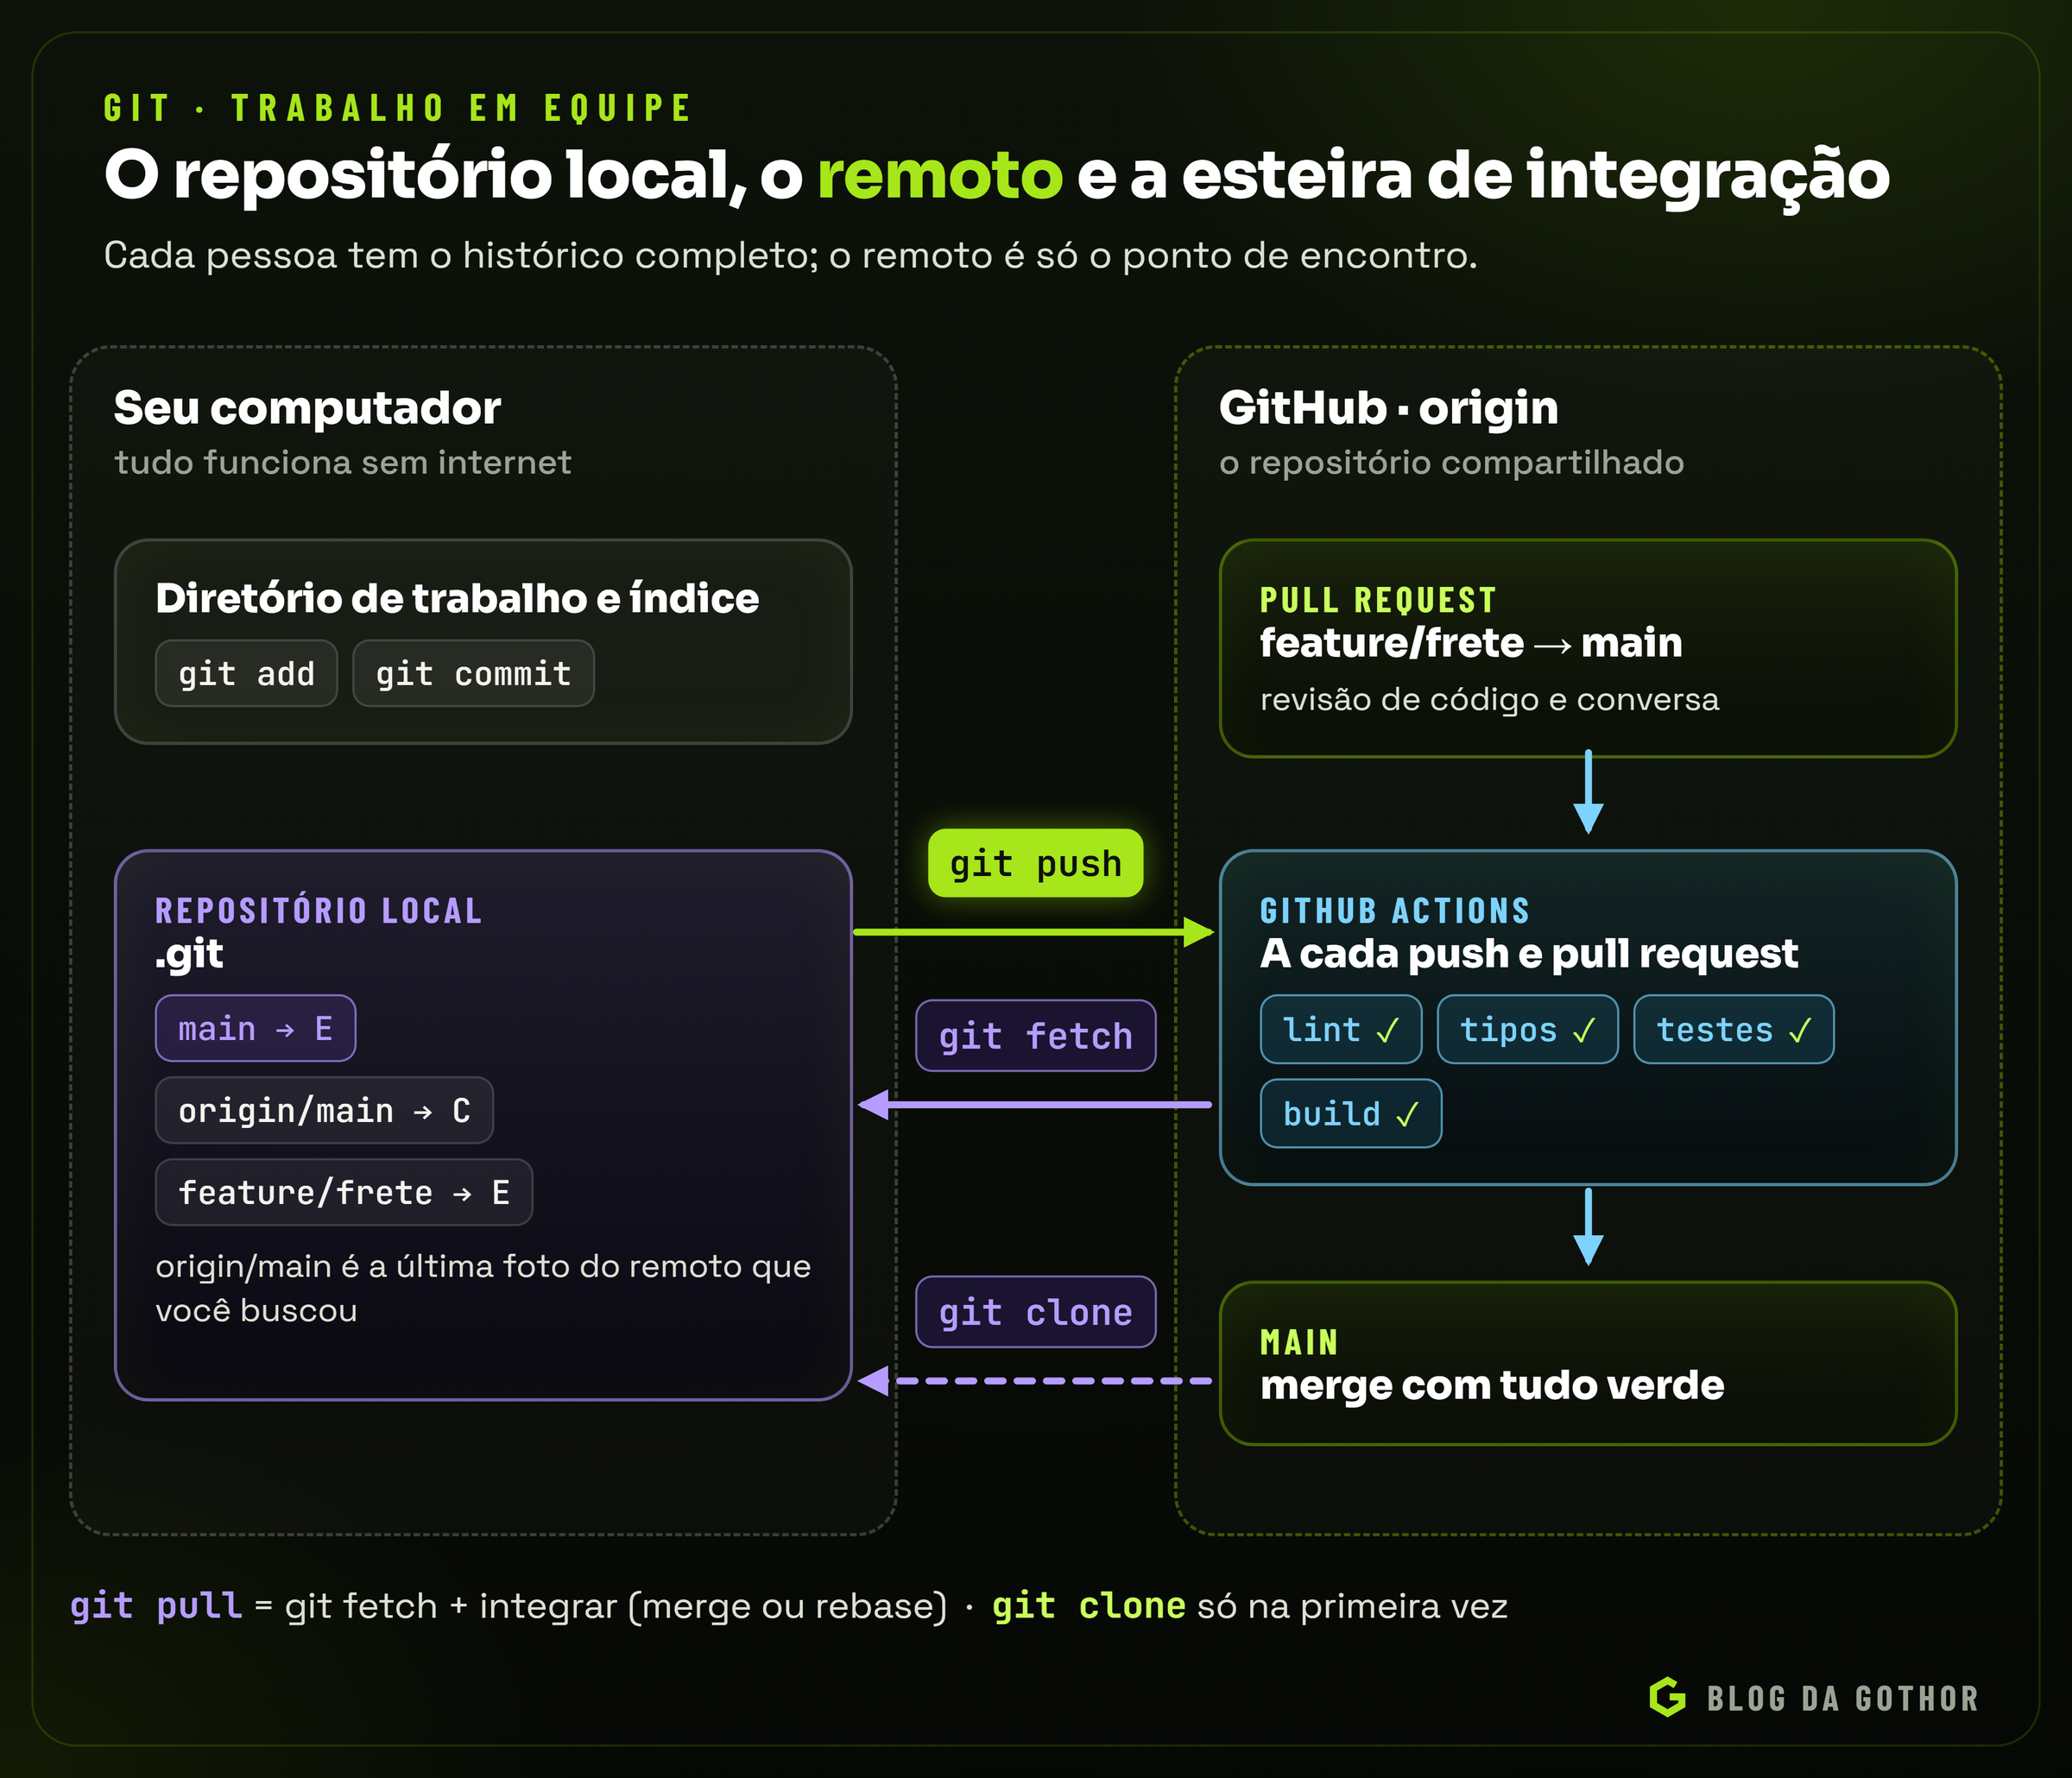
O origin/main merece atenção: ele é a última foto do remoto que você buscou, e não o remoto em tempo real. Por isso um git log origin/main pode estar desatualizado até o próximo fetch. Rodar git fetch antes de comparar ou integrar é um hábito que evita surpresas.
Quando um push é recusado com a mensagem de que o remoto tem commits que você não tem, o Git está protegendo o trabalho de outra pessoa. A resposta certa é buscar e integrar (git pull --rebase, por exemplo) e enviar de novo. Se você precisa mesmo sobrescrever um ramo seu que reescreveu com rebase, use git push --force-with-lease: ele só sobrescreve se o remoto ainda estiver como você o viu da última vez, o que evita apagar sem querer um commit que alguém enviou nesse meio-tempo.
Algumas configurações deixam o dia a dia mais previsível:
git config --global init.defaultBranch main   # nome do primeiro ramo em repositórios novos
git config --global pull.rebase true          # pull com rebase, sem commits de merge à toa
git config --global fetch.prune true          # remove origin/ramos que já foram apagados no remoto
git config --global rerere.enabled true       # reaproveita resoluções de conflito
O que acontece num fetch e num push
A sincronização entre dois repositórios Git é uma conversa sobre objetos que um tem e o outro não. Num git fetch, o servidor começa anunciando as referências que possui e o hash de cada uma. O cliente compara com o que já tem e responde com duas listas: os commits que quer (want) e os commits que já possui (have). Com isso, o servidor calcula exatamente quais objetos faltam do lado do cliente, monta um packfile só com eles, já comprimido com deltas, e o envia de uma vez. No fim, o cliente atualiza os ramos de rastreamento remoto.
O git push é a mesma conversa no sentido contrário. O cliente descobre o que o servidor já tem, envia um packfile com os objetos que faltam e pede que o servidor mova as referências. É nesse pedido que o servidor verifica se o movimento é um fast-forward, ou seja, se o commit novo descende do commit atual do ramo. Se não for, o push é recusado, a menos que seja forçado. É também nesse momento que regras de proteção, como "a main só recebe commits por pull request", são aplicadas pelo serviço de hospedagem.
Duas consequências práticas. A primeira é que um fetch depois de um dia de trabalho da equipe costuma transferir pouquíssimos dados, porque só os objetos novos viajam, e viajam como deltas. A segunda é que o endereçamento por conteúdo torna a troca segura: o cliente confere o hash de cada objeto recebido, e um objeto adulterado no caminho simplesmente não bate. Desde 2020, o Git usa por padrão a versão 2 desse protocolo, em que o cliente pode pedir só as referências que interessam, o que faz diferença em repositórios com dezenas de milhares de ramos e tags.
HTTPS ou SSH: como o remoto sabe quem é você
O Git conversa com remotos principalmente por dois protocolos, e a diferença está na autenticação:
| Protocolo | Endereço | Como autentica | Bom para |
|---|---|---|---|
| HTTPS | https://github.com/empresa/projeto.git | usuário e token de acesso pessoal, guardados por um gerenciador de credenciais | começar rápido, redes que bloqueiam a porta do SSH, automações com tokens de escopo limitado |
| SSH | git@github.com:empresa/projeto.git | um par de chaves: a pública fica no serviço, a privada na sua máquina | uso diário em máquinas de desenvolvimento, sem digitar senha |
Os serviços de hospedagem deixaram de aceitar a senha da conta em operações do Git: no HTTPS, a senha foi substituída por tokens, que podem ter validade e permissões restritas a alguns repositórios. No SSH, o cuidado é proteger a chave privada com uma frase-senha e usar um agente de chaves para não digitá-la a cada operação. Nos dois casos, o princípio é o mesmo: uma credencial por pessoa e por máquina, que pode ser revogada sozinha se um computador for perdido.
Refspecs: o mapa entre os ramos de lá e os de cá
Quando você clona um repositório, o Git grava em .git/config uma linha como esta:
[remote "origin"]
    url = git@github.com:empresa/loja.git
    fetch = +refs/heads/*:refs/remotes/origin/*
A linha fetch é um refspec: ela diz que todos os ramos do remoto (refs/heads/*) devem ser copiados para os ramos de rastreamento locais (refs/remotes/origin/*). O sinal de + permite atualizar mesmo quando o movimento não é um fast-forward, porque o rastreamento remoto apenas reflete o que existe lá. É esse mapa que faz o ramo main do servidor aparecer como origin/main na sua máquina, sem nunca se misturar com o seu main local.
Cada ramo local também pode ter um upstream, o ramo remoto que ele acompanha. É ele que permite rodar só git push e git pull, sem argumentos, e que faz o git status dizer "seu ramo está 2 commits à frente e 1 atrás de origin/main". Esses números vêm de uma conta simples no grafo: os commits alcançáveis a partir do ramo local que não são alcançáveis a partir do upstream, e vice-versa. O primeiro push de um ramo novo define o upstream com git push -u origin feature/frete.
Pull requests e fluxos de trabalho
O pull request (ou merge request, no GitLab) não é um recurso do Git: é uma conversa em torno de um ramo, oferecida pelo serviço de hospedagem. Nele acontecem a revisão de código, os comentários e, cada vez mais, a integração contínua: a cada push, um serviço como o GitHub Actions instala as dependências, compila, roda os testes e marca o pull request como aprovado ou reprovado. Junto com regras de proteção do ramo principal, isso impede que um código que quebra o build chegue à main.
Na hora de integrar um pull request aprovado, os serviços costumam oferecer três botões, e cada um produz um histórico diferente:
| Opção | O que acontece na main | Vantagem | Custo |
|---|---|---|---|
| Merge commit | todos os commits do ramo entram, mais um commit de merge | preserva a história completa e o contexto de cada passo | grafo mais ramificado |
| Squash and merge | os commits do ramo viram um único commit novo | main linear, um commit por pull request, fácil de reverter | perde os passos intermediários; o ramo original não aparece como integrado |
| Rebase and merge | os commits do ramo são recriados sobre a main, sem commit de merge | main linear e com os commits individuais | os hashes mudam, e os commits precisam estar limpos |
O squash é popular porque transforma cada pull request numa unidade: um commit, uma mudança, um revert se der errado. A contrapartida aparece quando o ramo continua sendo usado depois do squash: como os commits originais não estão na main, o Git não os reconhece como integrados, e o próximo merge do mesmo ramo pode trazer conflitos estranhos. A regra prática é apagar o ramo depois de um squash e começar outro a partir da main atualizada.
Sobre esse mecanismo, as equipes organizam fluxos de trabalho diferentes:
| Fluxo | Como funciona | Combina com |
|---|---|---|
| Trunk-based | ramos curtos, de horas ou poucos dias, integrados na main com frequência | equipes que publicam continuamente e têm boa cobertura de testes |
| GitHub Flow | um ramo por mudança, pull request com revisão, merge na main e publicação | a maioria dos produtos web |
| Git Flow | ramos develop, release e hotfix além da main | produtos com versões numeradas e várias versões em manutenção |
Não existe fluxo certo em abstrato. O que existe é o fluxo que a sua equipe consegue seguir com disciplina, e quanto mais simples ele for, maior a chance de ser seguido.
Desfazer sem medo
A melhor notícia sobre o Git é que é muito difícil perder um trabalho que já foi commitado. Quase todo erro tem volta, desde que você conheça a ferramenta certa:
| Situação | Comando | O que faz |
|---|---|---|
| Quero descartar a edição de um arquivo | git restore arquivo | volta o arquivo para a versão do índice |
| Adicionei ao índice por engano | git restore --staged arquivo | tira do próximo commit, mantém a edição |
| Esqueci um arquivo no último commit (ainda local) | git add arquivo e git commit --amend | recria o último commit com o arquivo |
| Um commit publicado introduziu um erro | git revert hash | cria um commit novo que desfaz aquele |
| Quero desfazer commits locais e manter as mudanças | git reset --soft HEAD~2 | volta o ramo dois commits, mantém tudo no índice |
| Quero jogar fora commits locais de vez | git reset --hard HEAD~2 | volta o ramo e os arquivos; use com cuidado |
| Preciso trocar de ramo no meio de uma edição | git stash e depois git stash pop | guarda e recupera as mudanças em andamento |
| Fiz besteira e "perdi" um commit | git reflog | mostra por onde o HEAD passou, com os hashes |
A diferença entre revert e reset é a mais importante dessa tabela. O revert acrescenta um commit e não reescreve nada, então é o caminho para desfazer algo que já está no remoto. O reset move o ponteiro do ramo para trás e, por isso, só deve ser usado em commits que ainda não foram compartilhados.
O reflog é a rede de segurança. Ele registra, localmente, cada posição por onde o HEAD e os ramos passaram nos últimos meses. Um rebase que deu errado, um reset --hard precipitado ou um ramo apagado podem ser recuperados assim:
$ git reflog
3f1a2b9 HEAD@{0}: reset: moving to HEAD~2
86ce556 HEAD@{1}: commit: Calcula o frete por CEP
51d0a3b HEAD@{2}: commit: Corrige o total do carrinho

$ git switch -c resgate 86ce556   # cria um ramo no commit "perdido"
Quanto tempo um commit perdido sobrevive
O reflog não guarda nada para sempre, e vale saber os prazos. A limpeza fica a cargo do git gc, que o próprio Git dispara de tempos em tempos, quando os objetos soltos passam de cerca de 6.700. Pelos padrões documentados, as entradas do reflog vivem 90 dias; as que apontam para commits que deixaram de fazer parte do ramo, como os originais de um rebase ou de um commit --amend, vivem 30 dias; e os objetos que nada mais alcança só são apagados depois de duas semanas soltos. A coleta preserva tudo o que é alcançável a partir dos ramos, das tags, dos ramos remotos, do índice e dos próprios reflogs.
Na prática, um commit "perdido" num rebase de ontem quase certamente ainda está lá. O cuidado é com as exceções: o reflog é local, então um commit que só existia na máquina de outra pessoa não pode ser resgatado na sua; e um git gc --prune=now, rodado para economizar espaço, apaga na hora os objetos soltos que seriam a última chance de recuperação. Arquivos que nunca passaram por um git add também não têm volta, porque o Git nunca os viu.
O stash por dentro
O git stash parece um recurso à parte, mas é feito com as mesmas peças do resto do Git. Cada entrada é um commit cuja tree registra o diretório de trabalho, com dois pais: o commit em que o HEAD estava e um commit com o estado do índice. Por isso o stash pop consegue restaurar separadamente o que estava no índice e o que estava só no disco, com --index. A entrada mais recente fica em refs/stash, e as anteriores ficam no reflog dessa referência, o que explica os nomes stash@{0}, stash@{1} e até stash@{2.hours.ago}.
Essa construção tem uma consequência útil. Um stash drop feito por engano apaga a referência, mas o commit continua no banco de objetos até a próxima coleta, e o hash dele aparece na mensagem do próprio drop. Um git stash apply com esse hash traz o trabalho de volta.
Desfazer um merge
Reverter um commit comum é simples. Reverter um commit de merge exige dizer em relação a qual pai desfazer, porque o merge tem dois. A opção -m resolve: git revert -m 1 hash-do-merge desfaz as mudanças que o merge trouxe para o primeiro pai, em geral a main, e mantém a main como estava antes da integração.
O detalhe que pega muita equipe vem depois. Reverter um merge, nas palavras da documentação, declara que você nunca vai querer as mudanças trazidas por ele: os commits daquele ramo continuam no histórico, e o Git os considera integrados. Quando o ramo for corrigido e integrado de novo, o merge traz só os commits novos, e não os antigos, que foram revertidos. A saída é reverter o revert antes do novo merge, com git revert hash-do-revert, e só então integrar as correções. O projeto Git mantém um texto inteiro sobre o caso, o revert-a-faulty-merge, listado no fim deste artigo.
Ferramentas que poucos usam, e deveriam
Além do básico, o Git traz ferramentas de investigação que economizam horas:
- **
git bisect** encontra o commit que introduziu um erro por busca binária. Você marca um commit bom e um ruim, e o Git vai propondo commits no meio do caminho até isolar o culpado. Comgit bisect rune um script de teste, a busca é automática. Em mil commits, bastam cerca de dez passos. - **
git blame -w -C** mostra quem alterou cada linha pela última vez, ignorando mudanças de espaço em branco e seguindo linhas que foram movidas de outros arquivos. - **
git log -S "texto"** encontra os commits que adicionaram ou removeram um trecho de código. É a forma mais rápida de descobrir quando uma função apareceu ou sumiu. - **
git worktree add** cria um segundo diretório de trabalho ligado ao mesmo repositório, com outro ramo. Dá para revisar um pull request ou corrigir um problema urgente sem guardar o que você está fazendo. - **
git cherry-pick** copia um commit específico de um ramo para outro, útil para levar uma correção damainpara um ramo de versão. - Hooks são scripts que o Git executa em momentos definidos, como antes de cada commit (
pre-commit) ou antes de cada push (pre-push). Ferramentas como o Husky facilitam versioná-los junto com o projeto. - **
.gitattributes** define, por tipo de arquivo, o tratamento de fim de linha, quais arquivos são binários e como comparar formatos especiais. - Git LFS, partial clone e sparse checkout resolvem repositórios muito grandes: o primeiro tira arquivos binários pesados do histórico, os outros dois baixam só a parte do histórico ou das pastas de que você precisa.
git bisect, passo a passo
Suponha que o cálculo do frete esteja errado na versão de hoje e certo na v2.3, com duzentos commits entre as duas. O bisect faz uma busca binária nesse intervalo:
git bisect start
git bisect bad HEAD          # a versão de hoje tem o erro
git bisect good v2.3         # esta versão funcionava
# o Git faz checkout de um commit no meio do caminho; teste e responda:
git bisect good              # ou: git bisect bad
# ...repita até o Git mostrar "is the first bad commit"
git bisect reset             # volta ao ramo em que você estava
A cada resposta, o intervalo cai pela metade, e duzentos commits se resolvem em cerca de oito passos. Com um script de teste, o processo inteiro roda sozinho:
git bisect start HEAD v2.3
git bisect run ./teste-frete.sh
O status de saída do script é a resposta: 0 marca o commit como bom; de 1 a 127, como ruim; e o 125 diz que aquele commit não pode ser testado, porque não compila, por exemplo, e o Git escolhe outro vizinho. Qualquer outro status, de 128 para cima, interrompe a busca, e por isso um script que termina com exit -1, que vira 255, para o bisect em vez de marcar o commit. Dois recursos completam o quadro: git bisect skip pula manualmente um commit que não dá para testar, e os termos --term-old e --term-new trocam "bom" e "ruim" por palavras que façam sentido quando a busca é por uma mudança qualquer, como o commit que deixou um relatório mais lento ou o que corrigiu um erro. Num histórico com muitos merges, git bisect start --first-parent segue só a linha principal e aponta o merge que trouxe o problema, sem entrar nos commits do ramo.
Repositórios grandes
O desenho do Git supõe que cada cópia tenha tudo: todo o histórico, todos os arquivos. Em repositórios com décadas de história, milhões de arquivos ou binários pesados, isso significa clones de horas e um git status lento. Ao longo da série 2, o projeto ganhou um conjunto de recursos para esses casos, e boa parte deles serve também para repositórios comuns.
- Clone parcial. Com
git clone --filter=blob:none, o clone traz todos os commits e trees, mas não o conteúdo dos arquivos das versões antigas. Os blobs que faltam são buscados sob demanda, quando um comando precisa deles, de um remoto que o Git passa a tratar como prometedor (promisor), aquele que se compromete a entregar os objetos depois. O preço é precisar de rede para consultar o passado, e cada objeto que falta pode custar uma ida ao servidor. - Checkout esparso. O
git sparse-checkout set servicos/frete docsdeixa no disco só as pastas escolhidas, e o resto continua rastreado, sem aparecer no diretório de trabalho. O modo em cone, hoje o padrão, trabalha com pastas inteiras, o que permite ao Git decidir rápido o que entra, e é o que se recomenda. - Commit-graph. Um arquivo à parte com os dados de cada commit, como os pais, a tree e a data, para que comandos como
git log --graphegit merge-basenão precisem abrir e descompactar cada objeto. Com os filtros de Bloom por caminho, ativados por--changed-paths, ogit log -- pasta/arquivofica muito mais rápido. - Monitor do sistema de arquivos. Com
git config core.fsmonitor true, um processo do próprio Git acompanha as alterações no diretório pelos avisos do sistema operacional, como o inotify no Linux, e ogit statuspergunta a ele o que mudou, em vez de examinar cada arquivo. - Manutenção em segundo plano. O
git maintenance startagenda tarefas no agendador do sistema (o cron, os timers do systemd, o launchctl do macOS ou o Agendador de Tarefas do Windows): atualizar o commit-graph de hora em hora, reagrupar objetos todo dia e buscar objetos novos dos remotos com antecedência. Essa busca antecipada grava emrefs/prefetch/e não mexe nos seusorigin/*, então o próximogit fetchsó precisa mover os ponteiros.
O Scalar, que vem junto com o Git, junta tudo isso num comando: scalar clone cria um clone que traz de início só os commits e as trees, liga o checkout esparso, registra a manutenção em segundo plano e aplica as configurações recomendadas para repositórios grandes. Para um repositório pequeno, nada disso é necessário; para o monorepositório de uma empresa com anos de história, a diferença entre usar ou não esses recursos se mede em minutos por dia de cada pessoa da equipe.
Boas mensagens de commit
O histórico só é útil se der para lê-lo. Uma mensagem de commit boa responde a duas perguntas: o que mudou e por quê. O "como" já está no diff.
A convenção mais difundida tem uma primeira linha curta, que funciona como título, uma linha em branco e um corpo explicando o contexto:
Calcula o frete pelo CEP de destino

O valor fixo de frete deixava pedidos do interior com prejuízo. Agora o
cálculo usa a faixa de CEP do destino, com a tabela em src/frete.js.

- Faixas 78xxx-xxx com valor reduzido (entrega própria).
- Testes de unidade para as três faixas e para CEP inválido.
Algumas equipes adotam o padrão Conventional Commits, com prefixos como feat: e fix:, que permitem gerar changelogs e calcular versões automaticamente. Outras preferem títulos em linguagem natural. O formato importa menos do que a consistência e do que o corpo explicar a motivação. Daqui a um ano, ninguém vai lembrar por que aquela linha mudou, e o commit é o único lugar onde essa resposta pode estar.
Commits pequenos e coesos também fazem parte disso. Um commit que mistura uma correção, uma refatoração e uma mudança de formatação é difícil de revisar, difícil de reverter e inútil para o bisect.
Segurança: assinaturas, segredos e hooks
O campo de autor de um commit é texto livre: qualquer pessoa pode configurar user.name e user.email com o nome de outra. Para provar a autoria, o Git permite assinar commits e tags, com chaves GPG ou, desde 2021, com a mesma chave SSH usada para acessar o remoto (git config --global gpg.format ssh e commit.gpgsign true). Os serviços de hospedagem conferem a assinatura e marcam o commit como verificado.
Segredos publicados são o incidente mais comum. Se uma senha ou um token chegou ao remoto, a correção tem três passos, nesta ordem: revogar e trocar a credencial, porque ela já pode ter sido copiada; só depois limpar o histórico, com uma ferramenta como o git filter-repo, recomendada pelo próprio projeto Git no lugar do antigo filter-branch; e avisar a equipe, porque a limpeza reescreve hashes. Para prevenir, os serviços oferecem varredura de segredos que bloqueia o push, e há ferramentas que fazem a mesma checagem num hook local.
Hooks, aliás, não vêm junto com um clone: a pasta .git/hooks não é versionada, justamente para que baixar um repositório não execute código de terceiros. Ferramentas como o Husky contornam isso de forma explícita: guardam os scripts numa pasta versionada e apontam o Git para ela com core.hooksPath, o que acontece quando a pessoa instala as dependências do projeto. Pelo mesmo motivo, desde 2022 o Git se recusa a operar num repositório cujo dono é outro usuário do sistema, a menos que a pasta seja declarada segura em safe.directory.
Erros comuns, e como evitar
- Commitar segredos. Senhas, tokens e arquivos
.envno repositório são o erro mais caro. Mantenha esses arquivos no.gitignoredesde o primeiro commit. Se um segredo chegou a ser publicado, troque o segredo: apagar o commit não basta, porque o histórico pode já estar em outras cópias. - Versionar arquivos gerados. Pastas como
node_modules,distebuildnão pertencem ao histórico. Elas são reproduzíveis a partir do código e só incham o repositório. - Binários grandes sem LFS. Cada versão de um arquivo binário grande fica para sempre no histórico, e todo clone a baixa.
- Rebase de ramo compartilhado e force-push sem lease. Os dois reescrevem um histórico que outras pessoas têm.
- Ramos que vivem semanas. Quanto mais tempo longe da
main, maiores os conflitos e o risco da integração. - Fim de linha misturado. Equipes com Windows, macOS e Linux devem padronizar o fim de linha com
.gitattributes(por exemplo,* text=auto), para que o diff não mostre arquivos inteiros alterados sem motivo. - Commits gigantes com a mensagem "ajustes". Eles tornam o histórico inútil justamente no dia em que você mais precisa dele.
- Medo do Git. Com
reflog,reverte--abortà mão, quase nada é irreversível. Antes de uma operação arriscada, criar um ramo de segurança (git branch backup) custa um segundo.
Como usamos o Git na Gothor
Na Gothor, todo o trabalho de produto passa pelo Git, e duas práticas deste artigo são regra na casa. A primeira é a mensagem de commit que explica o motivo da mudança, e não só o que mudou: é ela que permite entender uma decisão meses depois, quando ninguém mais lembra do contexto. A segunda é a verificação automática: cada mudança passa por testes e conferências antes de ser aceita, para que um erro apareça na hora, e não na operação de um cliente. Somam-se a isso cuidados simples, como nunca guardar credenciais no histórico e revisar o que entra antes de entrar.
Resumo
- O Git é distribuído: cada cópia tem o histórico completo, e quase tudo acontece localmente.
- Cada commit é uma foto completa do projeto, guardada como objetos (blob, tree, commit, tag) endereçados pelo hash do conteúdo.
- O índice é o rascunho do próximo commit, e o conteúdo é fotografado no
add;add,commit,restoreeswitchmovem arquivos entre as três áreas. - Ramos e tags são ponteiros para commits, e o HEAD diz onde você está. Criar um ramo custa quase nada, e a sintaxe das revisões (
HEAD~2,main..feature,@{u}) aponta para qualquer ponto do grafo. - O merge de três vias compara cada lado com o ancestral comum e acrescenta um commit com dois pais; o rebase recria commits sobre outra base e reescreve hashes. Não faça rebase do que já foi compartilhado.
fetchbusca,pullbusca e integra,pushenvia só os objetos que faltam, e--force-with-leaseé a forma segura de sobrescrever.- Com
revert,reset,stashereflog, quase todo erro tem volta, dentro dos prazos da coleta de lixo; reverter um merge exige-me, para reintegrar o ramo, reverter o revert. - O
.gitignorenão afeta arquivos já rastreados, egit check-ignore -vmostra qual regra ignora um caminho. - Clone parcial, checkout esparso, commit-graph, monitor do sistema de arquivos e manutenção em segundo plano mantêm repositórios grandes rápidos; SHA-256 e reftable são os padrões planejados para o Git 3.0.
- Assinaturas provam a autoria; um segredo publicado se resolve trocando a credencial antes de limpar o histórico.
- Mensagens claras, commits pequenos e integração contínua transformam o histórico numa ferramenta de trabalho.
Para ir além
- Documentação oficial do Git, o ponto de partida para tudo.
- Pro Git, em português, o livro completo e gratuito de Scott Chacon e Ben Straub.
- Git Internals: Git Objects, o capítulo do Pro Git sobre o banco de objetos.
- Referência dos comandos, com a página de cada comando, como git rebase, git switch, git restore, git reflog e git bisect.
- gitworkflows, as recomendações do próprio projeto Git sobre fluxos com ramos.
- Sintaxe das revisões e protocolo de transferência, para quem quer ir fundo nos dois assuntos.
- As mudanças planejadas para o Git 3.0, o formato reftable e o comando git refs.
- gitignore, git gc, git stash, git revert e o texto revert-a-faulty-merge, sobre desfazer um merge.
- Para repositórios grandes: clone parcial, git sparse-checkout, git maintenance e Scalar.
- git filter-repo, a ferramenta recomendada para reescrever o histórico, e assinatura de commits no GitHub.
- Documentação do GitHub Actions e pull requests no GitHub.
- Conventional Commits, a especificação de mensagens com prefixos.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.